Blog

  • ENS, NIS2, DORA y AI Act: cómo saber qué normativa aplica

    ENS, NIS2, DORA y AI Act: cómo saber qué normativa aplica

    La pregunta parece sencilla: qué normativa aplica a una empresa. La respuesta, casi nunca lo es. Una misma organización puede estar sometida al Esquema Nacional de Seguridad, al RGPD, a NIS2, a DORA, al Reglamento de IA, a eIDAS, al Data Act, a normas sectoriales de telecomunicaciones, contratación pública, protección de infraestructuras críticas o incluso a estándares como ISO 27001, NIST o CIS por exigencia contractual.

    El problema no es solo jurídico. También es operativo. Cumplir no consiste en tener una lista de normas en una matriz de Excel, sino en traducir obligaciones dispersas en controles, políticas, evidencias y responsabilidades que funcionen dentro de la organización. Por eso, en tecnología y ciberseguridad, la primera pregunta no debería ser “qué norma me aplica”, sino “qué servicios presto, a quién, con qué datos, en qué sector y bajo qué dependencias críticas”.

    La norma depende del servicio, no del logo de la empresa

    Una empresa puede ser una consultora tecnológica, un proveedor cloud, una entidad financiera, un operador de servicios gestionados, una plataforma de datos, un proveedor de firma electrónica o una compañía que presta servicios a la Administración. Cada una de esas actividades cambia el mapa de cumplimiento.

    El ENS, por ejemplo, tiene sentido cuando se prestan servicios a administraciones públicas o cuando se gestionan sistemas que dan soporte a servicios públicos digitales. No se trata solo de “ser tecnológico”, sino de formar parte de un entorno donde la seguridad de la información pública exige medidas concretas, categorización de sistemas, controles y auditoría.
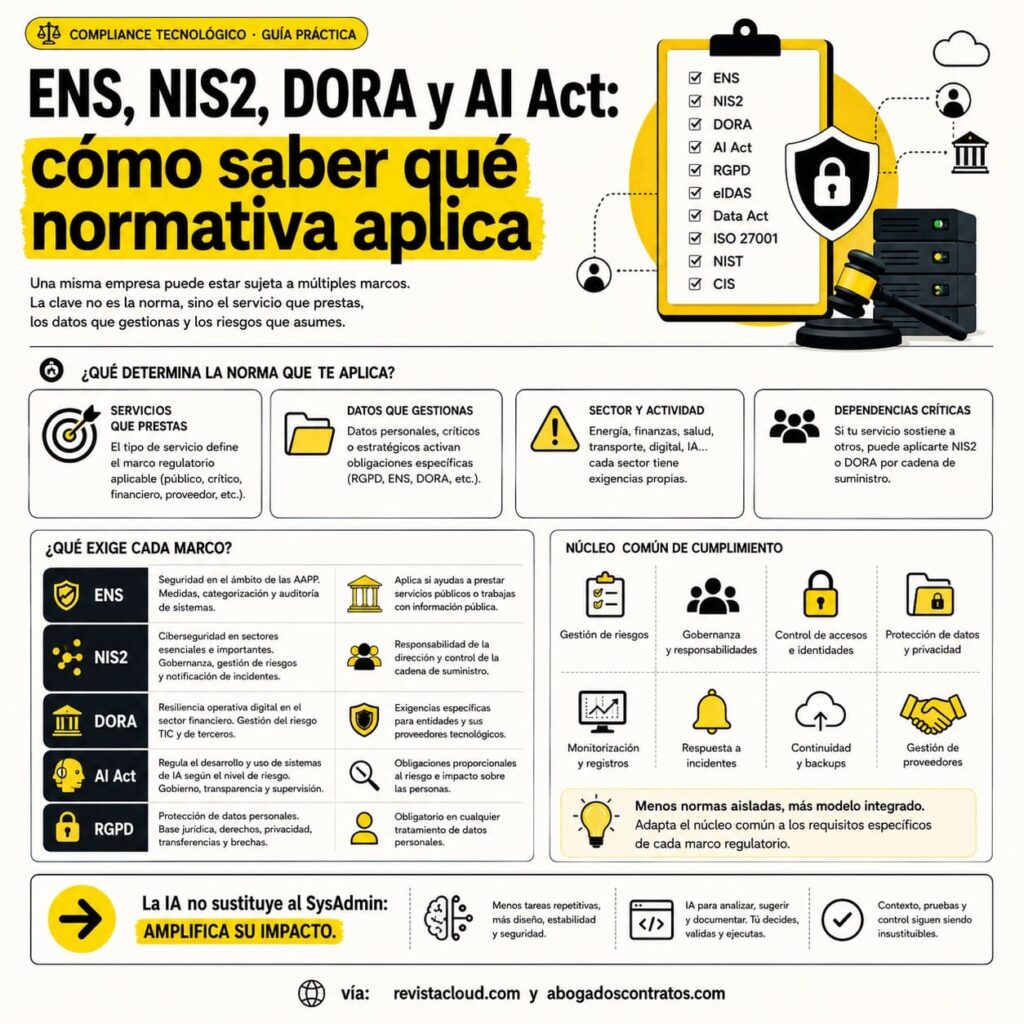
    NIS2 se mueve en otro plano. La directiva europea busca elevar el nivel común de ciberseguridad en sectores esenciales e importantes, con más peso en gobernanza, gestión de riesgos, continuidad, notificación de incidentes y cadena de suministro. Su impacto no se limita a empresas que se consideran “críticas” en sentido clásico. También puede alcanzar a proveedores tecnológicos que sostienen servicios relevantes para terceros.

    DORA, en cambio, mira de forma específica al sector financiero y a su resiliencia operativa digital. Bancos, aseguradoras, entidades de pago, empresas de inversión y otros actores financieros deben gestionar el riesgo TIC con especial rigor. Además, la norma pone un foco muy claro en los proveedores tecnológicos externos, porque la resiliencia de una entidad financiera depende cada vez más de cloud, software, comunicaciones, ciberseguridad y servicios gestionados.

    El Reglamento de IA añade otra capa. No pregunta solo si una empresa usa tecnología, sino para qué usa inteligencia artificial, con qué nivel de riesgo, sobre qué personas y en qué contexto. Un chatbot interno no plantea los mismos problemas que un sistema de selección de personal, scoring crediticio, biometría, vigilancia, educación, salud o infraestructuras críticas.

    La consecuencia es clara: dos empresas parecidas desde fuera pueden tener obligaciones muy distintas. Y dos servicios dentro de la misma empresa pueden estar sometidos a marcos diferentes.

    El núcleo común: menos normas aisladas y más modelo integrado

    La acumulación regulatoria genera una sensación de caos. ENS, NIS2, DORA, RGPD, AI Act, eIDAS, Data Act, Data Governance Act, CER, normativa de infraestructuras críticas, telecomunicaciones, ISO 27001, NIST, CIS. La lista crece y cada marco tiene su propio lenguaje.

    Pero cuando se baja al terreno técnico y organizativo, muchas obligaciones se repiten con matices. Casi todas exigen identificar riesgos, asignar responsabilidades, controlar accesos, proteger identidades, gestionar vulnerabilidades, monitorizar eventos, conservar evidencias, responder incidentes, probar continuidad, revisar proveedores y formar a las personas.

    Ahí está la oportunidad para despachos, consultoras, responsables de cumplimiento, CISOs y equipos legales internos. En lugar de construir un programa distinto para cada norma, conviene diseñar un núcleo común de cumplimiento. Ese núcleo debe servir como base y después adaptarse a los requisitos específicos de cada marco.

    La diferencia está en la profundidad. El RGPD obliga a pensar en base jurídica, derechos de los interesados, encargados de tratamiento, privacidad desde el diseño, transferencias internacionales y brechas de datos personales. DORA exigirá pruebas de resiliencia, gestión del riesgo TIC y control específico sobre terceros tecnológicos. NIS2 refuerza la responsabilidad de los órganos de dirección y las medidas organizativas y técnicas. El AI Act introduce gobierno del ciclo de vida de sistemas de IA, documentación, supervisión humana y gestión de riesgos según categoría. El ENS baja más al control concreto y a la demostración de conformidad.

    No son piezas intercambiables, pero sí pueden apoyarse sobre una misma arquitectura de gobierno.

    El error de convertir compliance en burocracia

    El cumplimiento tecnológico se degrada cuando se convierte en una fábrica de documentos que nadie usa. Políticas copiadas, registros sin actualizar, mapas de riesgos genéricos y procedimientos que no coinciden con la operación real dan una falsa sensación de seguridad.

    En un procedimiento judicial, una inspección, una auditoría o una investigación tras un incidente, la pregunta relevante no será solo si la empresa tenía una política aprobada. Será si esa política estaba implantada, si había responsables claros, si existían evidencias, si los controles eran proporcionados y si las decisiones podían reconstruirse.

    Por eso el cumplimiento debe conectarse con los sistemas reales: IAM, MFA, EDR, SIEM, gestión de parches, inventario de activos, CMDB, ticketing, contratos con proveedores, cláusulas de seguridad, planes de continuidad, backups, registros de formación y actas de comités. La evidencia no debería fabricarse al final. Debería generarse de forma natural en la operación diaria.

    También conviene separar lo obligatorio de lo recomendable. ISO 27001, NIST CSF o CIS Controls no son leyes europeas por sí mismas, pero pueden convertirse en exigencias prácticas cuando aparecen en contratos, pliegos, auditorías, pólizas de ciberseguro o compromisos con clientes. En muchos casos ayudan a ordenar el cumplimiento legal, aunque no sustituyen el análisis jurídico de aplicabilidad.

    Qué deberían hacer las organizaciones

    El primer paso es mapear servicios. No basta con describir la empresa por su CNAE o por su marca comercial. Hay que identificar qué servicios presta, qué clientes tiene, si trabaja con sector público, si opera en sectores esenciales, si procesa datos personales sensibles, si presta servicios TIC a entidades reguladas, si utiliza IA en procesos de alto riesgo o si forma parte de una cadena de suministro crítica.

    El segundo paso es construir una matriz de aplicabilidad. Cada norma debe vincularse a servicios concretos, no a la organización en abstracto. Esa matriz debe indicar obligaciones, responsables, evidencias, controles existentes, brechas y prioridad de actuación.

    El tercer paso es crear un catálogo común de controles. Gestión de riesgos, gobierno, identidades, accesos, MFA, vulnerabilidades, monitorización, logs, incidentes, continuidad, proveedores, formación y auditoría. A partir de ahí se añaden capas específicas: privacidad para RGPD, resiliencia TIC para DORA, categorización y medidas del ENS, gobierno de IA para AI Act, requisitos de datos para Data Act o identificación electrónica y servicios de confianza en eIDAS.

    El cuarto paso es asignar propiedad. Legal no puede cumplir solo. Sistemas tampoco. Seguridad, compliance, compras, recursos humanos, dirección, negocio y proveedores deben participar. La normativa tecnológica moderna tiene una característica común: exige gobierno, no solo controles técnicos.

    La verdadera madurez llega cuando la empresa deja de preguntar “qué documento necesito” y empieza a preguntar “qué riesgo estoy gestionando, con qué control, quién responde y cómo lo demuestro”. Ese cambio reduce duplicidades, baja el ruido regulatorio y permite que el cumplimiento deje de ser un coste defensivo para convertirse en una forma de ordenar la organización.

    Preguntas frecuentes

    ¿Puede aplicarme más de una normativa a la vez?
    Sí. Es habitual que una misma empresa esté sometida a privacidad, ciberseguridad, resiliencia, IA, datos y obligaciones sectoriales al mismo tiempo, sobre todo si presta servicios tecnológicos o trabaja con sectores regulados.

    ¿ISO 27001, NIST o CIS son obligatorios?
    No son leyes europeas en sí mismos, pero pueden ser exigibles por contrato, licitación, auditoría, cliente, aseguradora o política interna. También sirven como base práctica para ordenar controles.

    ¿Cuál es el primer paso para saber qué normativa aplica?
    Identificar los servicios que presta la organización, los sectores a los que sirve, los datos que trata, sus proveedores críticos y si opera con Administración pública, entidades financieras, infraestructuras críticas o sistemas de IA.

    ¿Qué es mejor: cumplir norma por norma o crear un modelo común?
    Lo más eficiente suele ser crear un núcleo común de controles y después añadir requisitos específicos por norma. Así se evitan duplicidades y se facilita la generación de evidencias.
  • Prohibir la IA en el pie del correo no basta para proteger tus datos

    Prohibir la IA en el pie del correo no basta para proteger tus datos

    La idea tiene fuerza: añadir al pie del correo una cláusula que prohíba expresamente analizar, resumir, indexar, vectorizar o reutilizar el mensaje y sus adjuntos mediante sistemas de inteligencia artificial. En plena adopción de Copilot, Gemini, ChatGPT, Claude o Perplexity dentro de empresas, despachos y administraciones, el aviso suena como una reacción lógica ante una preocupación real: qué ocurre cuando un correo confidencial acaba tratado por una IA sin autorización clara.

    El debate, planteado estos días por Iñaki Jauregui Navarro en LinkedIn, toca un punto sensible para cualquier organización. Los correos electrónicos contienen datos personales, información contractual, documentación interna, propiedad intelectual, secretos empresariales y, en muchos casos, datos de terceros. Usarlos alegremente en herramientas de IA generativa puede generar riesgos legales, técnicos y reputacionales. Pero convertir un pie de correo en una barrera efectiva frente a ese tratamiento es mucho más difícil de lo que parece.

    El disclaimer tiene valor, pero no hace magia

    Un aviso al final del correo puede servir como señal de voluntad, recordatorio de confidencialidad y elemento disuasorio para quien pensaba copiar el contenido en una herramienta externa sin pensarlo demasiado. También puede ayudar a dejar constancia de que el remitente no autoriza ciertos usos del mensaje, especialmente cuando hay una relación profesional previa y una expectativa razonable de confidencialidad.

    El problema es su eficacia práctica. La mayoría de usuarios no lee los disclaimers. Muchos pies de correo se han convertido en bloques automáticos, extensos y repetidos que los destinatarios ignoran por costumbre. Si alguien decide conscientemente pegar un contrato, una propuesta comercial o un informe con datos personales en un chatbot público, es dudoso que una nota al final del email sea lo que le haga detenerse.

    La segunda grieta es más importante: cada vez más el tratamiento con IA no depende de una acción visible del destinatario. En entornos de Microsoft 365 o Google Workspace, las funciones de IA se integran en el flujo diario de trabajo. Pueden resumir hilos, sugerir respuestas, buscar información en documentos, asistir en reuniones o conectar con datos almacenados en el tenant. Microsoft afirma que los prompts, respuestas y datos accesibles mediante Microsoft Graph en Microsoft 365 Copilot no se usan para entrenar sus modelos fundacionales; Google también sostiene que Gemini en Workspace no entrena sus modelos con los datos de los clientes. Eso reduce un riesgo concreto, el entrenamiento, pero no elimina otro: el tratamiento automatizado de la información dentro de la propia organización.

    Ahí el pie de correo se queda corto. Una persona puede infringir una prohibición sin haber pulsado un botón de “usar IA”. Puede bastar con que su empresa tenga activadas funciones de resumen, búsqueda semántica, clasificación o asistencia generativa sobre buzones y documentos. El riesgo no está solo en el usuario que copia y pega. Está en la configuración de la plataforma.

    RGPD: el centro no es la IA, es el tratamiento

    Desde el punto de vista jurídico, la pregunta no debería formularse solo como “¿pueden usar mi correo con IA?”, sino como “¿qué tratamiento se está haciendo, con qué base jurídica, para qué finalidad, con qué garantías y por cuenta de quién?”. El Reglamento General de Protección de Datos obliga a que todo tratamiento de datos personales respete principios como licitud, lealtad, transparencia, minimización, limitación de finalidad, integridad, confidencialidad y responsabilidad proactiva. También exige contar con una base jurídica válida para el tratamiento.

    Esto implica que una empresa no puede resolver el problema diciendo simplemente que “la IA viene incluida en la herramienta”. Si los correos contienen datos personales y esos datos son procesados por sistemas de IA, la organización debe analizar el tratamiento, documentarlo, configurar adecuadamente la herramienta, limitar accesos, revisar contratos con proveedores, evaluar riesgos y formar a sus empleados.

    La AEPD lleva tiempo publicando orientaciones sobre inteligencia artificial, IA generativa y sistemas agénticos desde la perspectiva de protección de datos. La cuestión no es solo si un modelo entrena o no con la información, sino cómo se implementa la herramienta, qué datos procesa, qué decisiones facilita, qué trazabilidad existe y quién mantiene el control efectivo del tratamiento.

    También el Comité Europeo de Protección de Datos ha abordado el uso de datos personales en modelos de IA, incluyendo cuándo puede considerarse anónimo un modelo, cómo valorar el interés legítimo y qué ocurre si un modelo se desarrolla con datos tratados ilícitamente. La anonimización, además, no es una etiqueta que se pega a un proceso: debe impedir razonablemente la identificación de personas, algo especialmente delicado cuando hablamos de grandes modelos y extracción de información.

    La cláusula de 10.000 euros no lo arregla todo

    Algunas propuestas de disclaimer incorporan una cláusula de daños mínimos, por ejemplo 10.000 euros, si el destinatario trata el correo con IA sin autorización. Es una fórmula llamativa, pero su eficacia dependerá mucho del contexto. No es lo mismo una condición pactada en un contrato, unas normas aceptadas dentro de una relación mercantil o un acuerdo de confidencialidad firmado, que una advertencia unilateral añadida automáticamente al pie de un correo.

    Para que una reclamación prospere no bastará con decir “mi pie de correo lo prohibía”. Habrá que acreditar qué tratamiento se hizo, quién lo realizó, con qué herramienta, qué datos se incorporaron, si hubo cesión a terceros, si existió incumplimiento contractual o normativo, qué daño se produjo y si la cuantificación reclamada es razonable. Además, identificar una respuesta “con formato de LLM” como prueba suficiente puede ser problemático: un texto bien redactado no demuestra por sí solo que haya pasado por un modelo.

    Eso no significa que el aviso sea inútil. Puede reforzar la posición del remitente, ayudar a fijar expectativas y servir como advertencia frente a usos deliberados. Pero no conviene presentarlo como una solución legal completa. La verdadera protección exige gobernanza, no solo una frase al final de cada email.

    La batalla está en la configuración de las plataformas

    El terreno decisivo está en los tenants corporativos, las políticas internas y los contratos con proveedores. Las organizaciones que usan Microsoft 365, Google Workspace u otras suites deben decidir qué funciones de IA activan, para qué grupos, con qué permisos, sobre qué repositorios y bajo qué controles. También deben revisar si los asistentes pueden acceder a buzones, chats, documentos, grabaciones o adjuntos con información confidencial.

    Una buena política interna debería distinguir entre herramientas aprobadas y no aprobadas, datos que pueden tratarse con IA, información excluida, requisitos de anonimización o seudonimización, uso de proveedores externos, conservación de prompts y respuestas, registros de auditoría y responsabilidades de cada equipo. El Reglamento de IA de la Unión Europea, en vigor desde el 1 de agosto de 2024 y con aplicación plena prevista de forma general desde el 2 de agosto de 2026, añade además nuevas obligaciones de gobernanza, transparencia y gestión del riesgo para determinados sistemas y proveedores.

    El aviso en el pie del correo puede formar parte de esa estrategia, pero no sustituirla. La organización que recibe información de terceros debe tener controles propios para evitar que datos confidenciales acaben en herramientas no autorizadas o en funciones de IA mal configuradas. Y quien envía información sensible debería pensar también en medidas adicionales: acuerdos de confidencialidad, canales seguros, restricciones contractuales, clasificación documental, cifrado, marcas de confidencialidad y comunicación clara antes del envío.

    La discusión sobre los disclaimers de IA es útil porque pone nombre a una inquietud que muchas empresas aún no han resuelto. Pero la respuesta no está en confiar en que todo el mundo lea un pie de correo. Está en asumir que la IA ya forma parte de las herramientas de trabajo y que, por tanto, debe gestionarse como cualquier otro tratamiento relevante de datos: con base jurídica, controles técnicos, responsabilidades claras y capacidad real de auditoría.

    Preguntas frecuentes

    ¿Sirve de algo prohibir el uso de IA en el pie del correo?
    Puede servir como aviso y como elemento disuasorio, pero por sí solo no garantiza que el contenido no sea tratado por sistemas de IA ni asegura automáticamente una reclamación.

    ¿Copilot o Gemini entrenan sus modelos con correos corporativos?
    Microsoft y Google afirman que los datos empresariales de Microsoft 365 Copilot y Google Workspace Gemini no se usan para entrenar sus modelos fundacionales. Aun así, esas herramientas sí pueden tratar datos dentro del entorno corporativo para ofrecer funciones como resumen, búsqueda o asistencia.

    ¿Qué debería hacer una empresa antes de usar IA con correos y documentos?
    Debe revisar la base jurídica, contratos con proveedores, configuración de permisos, políticas internas, trazabilidad, formación de empleados y límites sobre qué información puede tratarse con IA.

    Imagen vía LinkedIN

  • Medios locales llevan a juicio a OpenAI y Microsoft por entrenar IA

    Medios locales llevan a juicio a OpenAI y Microsoft por entrenar IA

    Un nuevo frente judicial vuelve a situar a la inteligencia artificial generativa ante una pregunta que los tribunales estadounidenses todavía no han cerrado: hasta dónde puede llegar el uso de obras protegidas para entrenar modelos de lenguaje. Un grupo de editoras de prensa local y regional ha presentado una demanda contra Microsoft y varias entidades de OpenAI ante el Tribunal Federal del Distrito Sur de Nueva York por presunta infracción de derechos de autor y vulneración de la Digital Millennium Copyright Act (DMCA).

    La demanda, fechada el 24 de junio de 2026, agrupa a compañías que, según el escrito, operan casi 400 periódicos y medios locales en 33 estados de Estados Unidos. Los demandantes sostienen que OpenAI y Microsoft habrían rastreado, copiado e incorporado a sus sistemas cientos de miles de artículos periodísticos sin autorización, incluidos contenidos publicados tras muros de pago y restricciones de acceso. El uso denunciado se vincula a productos como ChatGPT, ChatGPT Enterprise, Copilot, Azure OpenAI Service y Microsoft 365 Copilot.

    El procedimiento está en fase inicial y recoge la versión de los demandantes. No hay, por tanto, una declaración judicial sobre la veracidad de las acusaciones. Pero el caso es relevante porque combina tres planos jurídicos de gran impacto para el sector tecnológico y editorial: la posible infracción directa de copyright en el entrenamiento de modelos, la responsabilidad de Microsoft como socio e integrador de OpenAI y la retirada de información de gestión de derechos de autor, una cuestión que puede tener recorrido propio bajo la DMCA.

    Una demanda construida sobre copyright, DMCA y responsabilidad vicaria

    El escrito de demanda formula tres grandes bloques de reclamación. El primero es una acción por infracción de copyright al amparo del Copyright Act estadounidense. No se plantea por todos los demandantes, sino por aquellos que identifican obras registradas, entre ellos Arkansas Democrat-Gazette, Concord Publishing House, H.S. Gere & Sons, The New Mexican y Newspapers of New Hampshire. Esta distinción es relevante porque, en el sistema estadounidense, el registro de la obra ante la Copyright Office condiciona la posibilidad de reclamar determinados remedios por infracción.

    El segundo bloque es una reclamación por responsabilidad vicaria frente a Microsoft y varias entidades de OpenAI. La tesis de los demandantes es que Microsoft no habría actuado como mero inversor pasivo, sino como socio tecnológico y comercial decisivo en la infraestructura, entrenamiento, despliegue e integración de los modelos GPT. Según la demanda, Microsoft habría aportado infraestructura cloud, habría obtenido acceso preferente a modelos y habría incorporado esas capacidades en productos propios como Copilot.

    El tercer bloque se apoya en la DMCA, en concreto en la retirada o alteración de copyright management information (CMI). Los editores sostienen que OpenAI habría eliminado de los contenidos elementos como titulares, nombres de autores, nombres de publicación, avisos de copyright y condiciones de uso durante el proceso de extracción y preparación de datasets.

    ReclamaciónDemandantes afectadosBase jurídicaQué se discute
    Infracción directa de copyrightEditores con obras registradasCopyright Act, 17 U.S.C. § 501Copia, entrenamiento, almacenamiento y outputs
    Responsabilidad vicariaFrente a Microsoft y entidades de OpenAIDoctrina de responsabilidad por control y beneficioPapel de Microsoft y estructura de OpenAI
    Retirada de CMITodos los demandantesDMCA, 17 U.S.C. § 1202Eliminación de autoría, copyright y condiciones de uso
    Medidas cautelares e injunctionTodos o parte de los demandantesCopyright Act y remedios equitativosCese de conductas y retirada de copias

    Esta arquitectura procesal no es casual. El debate sobre el entrenamiento de modelos con contenido protegido suele centrarse en el fair use, pero las reclamaciones bajo la DMCA pueden abrir una vía distinta. Si un tribunal considera que se retiró conscientemente información de gestión de derechos con conocimiento de que ello podía facilitar o encubrir infracciones, el análisis no se agota en si el entrenamiento es o no transformativo.

    El punto delicado: no solo entrenar, también extraer y despojar de atribución

    La demanda no se limita a afirmar que los modelos fueron entrenados con artículos de prensa. Alega un proceso más concreto: rastreo automatizado de webs, copia de artículos en servidores propios, extracción del cuerpo principal de los textos y eliminación de información asociada a la titularidad de derechos.

    Los demandantes citan herramientas y metodologías de extracción de contenido, como Dragnet y Newspaper, para sostener que esos sistemas separan el cuerpo del artículo de otros elementos de la página. En términos técnicos, esa operación puede explicarse como limpieza de HTML, eliminación de menús, publicidad, navegación o pie de página. En términos jurídicos, los demandantes sostienen que esa limpieza habría eliminado también información protegida por la DMCA.

    Ahí está una de las claves del caso. Para una empresa de IA, eliminar ruido de una página web puede parecer una fase necesaria para entrenar modelos con texto limpio. Para un titular de derechos, si en ese proceso desaparecen autoría, aviso de copyright, nombre del medio y términos de uso, la extracción puede convertirse en una conducta jurídicamente sensible.

    Elemento eliminado, según la demandaRelevancia jurídica alegada
    Nombre del autorIdentifica autoría y procedencia
    Nombre de la publicaciónVincula el texto con su editor
    Aviso de copyrightInforma de protección jurídica
    Términos de usoDefine condiciones de acceso y reutilización
    Título y metadatosAyudan a rastrear la obra
    Enlaces a condicionesRefuerzan la reserva de derechos

    La reclamación bajo la DMCA puede ser especialmente importante para medios que no tengan todas sus obras registradas. En Estados Unidos, una acción por retirada de CMI no exige el mismo presupuesto registral que una reclamación clásica de copyright. Por eso el pleito puede interesar no solo a grandes grupos, sino también a cabeceras pequeñas con recursos limitados.

    Paywalls, Common Crawl y datasets: el problema probatorio

    Otro punto que previsiblemente marcará el procedimiento será la prueba. OpenAI no publica de forma detallada los datasets usados para entrenar sus modelos más recientes. Los demandantes intentan suplir esa falta de transparencia con análisis de datasets relacionados o aproximaciones abiertas, como OpenWebText y C4, un subconjunto filtrado de Common Crawl.

    Según la demanda, análisis realizados para los demandantes habrían localizado millones de tokens procedentes de sus webs en esos conjuntos. En el caso de C4, el escrito afirma que las webs de los editores suman más de 115 millones de tokens. El documento también sostiene que cientos de miles de artículos protegidos podrían haber estado presentes en materiales de entrenamiento usados para modelos GPT.

    Esta línea probatoria tiene una dificultad evidente. Que un contenido aparezca en Common Crawl, C4 u OpenWebText no demuestra por sí solo que se usara en un modelo concreto ni que el uso sea ilícito. Pero sí puede servir para construir una inferencia: si esos datasets forman parte del ecosistema de entrenamiento, y si contienen obras de los demandantes, la cuestión pasa a discovery. En esa fase, los editores intentarán obtener información interna sobre datasets, filtros, extracción, almacenamiento, entrenamiento, fine-tuning, RAG y generación de outputs.

    Cuestión probatoriaPor qué importa
    Presencia en datasets públicosIndicio de disponibilidad para entrenamiento
    Uso real en modelos GPTElemento central para acreditar copia o explotación
    Contenido bajo paywallPuede debilitar la defensa de acceso público
    Eliminación de CMIRefuerza la vía DMCA
    MemorizationPuede evidenciar reproducción sustancial
    RAG y búsqueda en tiempo realDesplaza el debate del entrenamiento al output
    Documentación internaSerá clave en discovery

    La demanda también insiste en la “memorización” de modelos. Según los editores, modelos GPT anteriores habrían reproducido textos de noticias de forma literal o casi literal ante determinados prompts en otros procedimientos. La acusación sostiene que, si los contenidos de los demandantes formaban parte de los datasets, también podrían haberse reproducido de forma similar. Esta parte será previsiblemente discutida por las defensas, tanto desde el punto de vista técnico como jurídico.

    Microsoft no queda al margen del litigio

    Una de las decisiones estratégicas del escrito es incluir a Microsoft como demandada principal y no como actor accesorio. La demanda recuerda la inversión de Microsoft en OpenAI y describe su relación como una colaboración técnica y comercial profunda. También apunta a la infraestructura de Azure utilizada para entrenar modelos y a la integración de GPT en productos de Microsoft.

    Para los abogados de propiedad intelectual y tecnología, esta parte del caso merece atención porque puede afectar a la cadena de responsabilidad en IA. Si una empresa entrena un modelo, otra lo aloja, otra lo integra y otra lo comercializa, ¿quién responde por el uso de obras protegidas? La demanda busca extender la responsabilidad a quien controla, facilita o se beneficia de la explotación del sistema, aunque no sea necesariamente quien seleccionó artículo por artículo.

    ActorPapel descrito en la demanda
    OpenAIDesarrollo, entrenamiento y comercialización de modelos GPT
    MicrosoftInfraestructura, inversión, integración y explotación comercial
    EditoresTitulares de contenidos periodísticos protegidos
    Usuarios finalesPosibles receptores de outputs generados
    TribunalDeberá valorar copyright, DMCA, fair use y remedios

    Si esta tesis prospera, proveedores cloud, integradores de IA y distribuidores de soluciones basadas en modelos ajenos podrían revisar con más cuidado sus cláusulas de indemnidad, auditoría de datasets, trazabilidad de fuentes y garantías contractuales sobre entrenamiento.

    Fair use frente a mercado de licencias

    OpenAI ha defendido en otros asuntos que el entrenamiento de modelos con información disponible públicamente queda amparado por el fair use. Esa será, previsiblemente, una de las defensas centrales. La compañía puede argumentar que el entrenamiento es transformativo, que los modelos no sustituyen a las obras concretas y que el uso de grandes cantidades de texto permite desarrollar sistemas con utilidad social y económica.

    Los editores, por su parte, plantean una lectura opuesta. Sostienen que sus artículos fueron copiados, almacenados, procesados y usados para construir productos comerciales de enorme valor. Además, alegan que esos productos pueden sustituir visitas a las webs originales, reducir ingresos por publicidad y suscripción, y erosionar el mercado de licencias de contenido.

    El cuarto factor del fair use, relativo al efecto sobre el mercado potencial de la obra, puede ser especialmente disputado. Si los tribunales consideran que existe un mercado razonable de licencias para entrenamiento de IA y que las empresas tecnológicas lo han eludido, la defensa se complica. Si, por el contrario, aceptan que el entrenamiento con contenido accesible públicamente es un uso transformativo que no sustituye la explotación normal de la obra, las tecnológicas ganarían margen.

    Factor de fair usePosible debate en el caso
    Propósito y carácter del usoEntrenamiento transformativo frente a explotación comercial
    Naturaleza de la obraPeriodismo factual, pero con expresión protegida
    Cantidad usadaCopia masiva frente a uso necesario para el modelo
    Efecto en el mercadoSustitución de tráfico, suscripciones y licencias
    PaywallsPuede afectar a la idea de disponibilidad pública
    CMIDebate paralelo bajo DMCA, no idéntico al fair use

    La existencia de acuerdos de licencia entre empresas de IA y algunos medios añade una capa más. Si el mercado ya está negociando licencias, los demandantes pueden sostener que hay una vía comercial viable. Las empresas de IA, en cambio, pueden responder que esos acuerdos son decisiones comerciales, no reconocimiento jurídico de obligación general.

    Qué piden los editores al tribunal

    La demanda solicita daños legales, daños compensatorios, restitución, disgorgement de beneficios, costas y honorarios. También pide medidas de cesación frente a las conductas consideradas ilícitas y, de forma destacada, una orden bajo 17 U.S.C. § 503(b) para que los demandados retiren todas las copias de las obras registradas de modelos GPT u otros LLM y de los conjuntos de entrenamiento.

    Esta petición plantea una dificultad técnica y jurídica considerable. Retirar una obra concreta de un dataset puede ser posible si se identifica el archivo de entrenamiento. Retirarla de un modelo ya entrenado es mucho más complejo. La cuestión de la “desinfección” o eliminación de obras de modelos entrenados puede convertirse en uno de los debates prácticos más importantes de estos litigios.

    Remedio solicitadoDificultad práctica
    Daños estatutariosDepende de obras registradas y voluntad infractora
    Daños realesRequiere acreditar perjuicio económico
    DisgorgementExige vincular beneficios con la infracción
    InjunctionDebe ajustarse a conducta y proporcionalidad
    Retirada de copias de datasetsPuede depender de trazabilidad documental
    Retirada de obras de modelosProblema técnico complejo
    Honorarios y costasPosibles si prosperan las reclamaciones

    Para el sector legal, la petición de retirada es tan importante como la de indemnización. Una sentencia que obligase a limpiar datasets o modelos cambiaría la gestión de riesgo de toda la industria. Incluso sin llegar a una sentencia, una fase de discovery amplia podría forzar a las compañías de IA a revelar más sobre sus procesos internos de recopilación y entrenamiento.

    Una demanda que puede acelerar la contratación de datos

    El caso se suma a una oleada de litigios de autores, medios y titulares de derechos contra empresas de IA. Su rasgo diferencial es el protagonismo de la prensa local y regional. Estos editores no solo reclaman una compensación por el pasado. También buscan proteger una cadena económica que depende de tráfico, suscripciones, publicidad y licencias.

    Para despachos, asesores internos y empresas tecnológicas, el mensaje es claro: la procedencia de los datos ya no puede tratarse como un asunto secundario de ingeniería. El entrenamiento de modelos, el fine-tuning, el RAG, los agentes que navegan por webs y la generación de respuestas con contenido recuperado en tiempo real tienen implicaciones contractuales, regulatorias y de propiedad intelectual.

    La diligencia debida en IA empieza a parecerse cada vez más a una due diligence de contenidos. Qué datos se usan, con qué título jurídico, bajo qué términos de uso, si hay reservas de derechos, si se han respetado paywalls, si se conserva CMI, si existen logs de origen, si hay mecanismos de exclusión y si los contratos con proveedores cubren reclamaciones de terceros.

    La demanda contra OpenAI y Microsoft no resolverá por sí sola el encaje legal de la IA generativa. Pero sí muestra hacia dónde se mueve el conflicto: del debate abstracto sobre si la IA “aprende como una persona” a una discusión documental, probatoria y contractual sobre copias, datasets, metadatos, términos de uso y dinero.

    Para la industria legal, esa es la señal más importante. La inteligencia artificial ya no se litiga solo como tecnología emergente. Se litiga como cadena de suministro de contenidos.

    Preguntas frecuentes

    ¿Qué tribunal tramita la demanda?
    La demanda se presentó ante el United States District Court for the Southern District of New York, con número de asunto 26-cv-5320.

    ¿Qué normas invocan los demandantes?
    El escrito invoca el Copyright Act estadounidense, la Digital Millennium Copyright Act y teorías de responsabilidad directa y vicaria por infracción de derechos de autor.

    ¿Por qué es importante la información CMI?
    Porque identifica autoría, titularidad, avisos de copyright y condiciones de uso. Su retirada consciente puede dar lugar a responsabilidad específica bajo la DMCA.

    ¿Qué puede cambiar si prospera la demanda?
    Podría reforzarse el mercado de licencias para entrenamiento de IA, aumentar las obligaciones de trazabilidad de datasets y elevar el riesgo jurídico para desarrolladores, proveedores cloud e integradores de modelos.

    Fuentes:
    Demanda Richner Communications, Inc. et al. v. Microsoft Corporation et al., U.S. District Court, Southern District of New York, 24/06/2026.

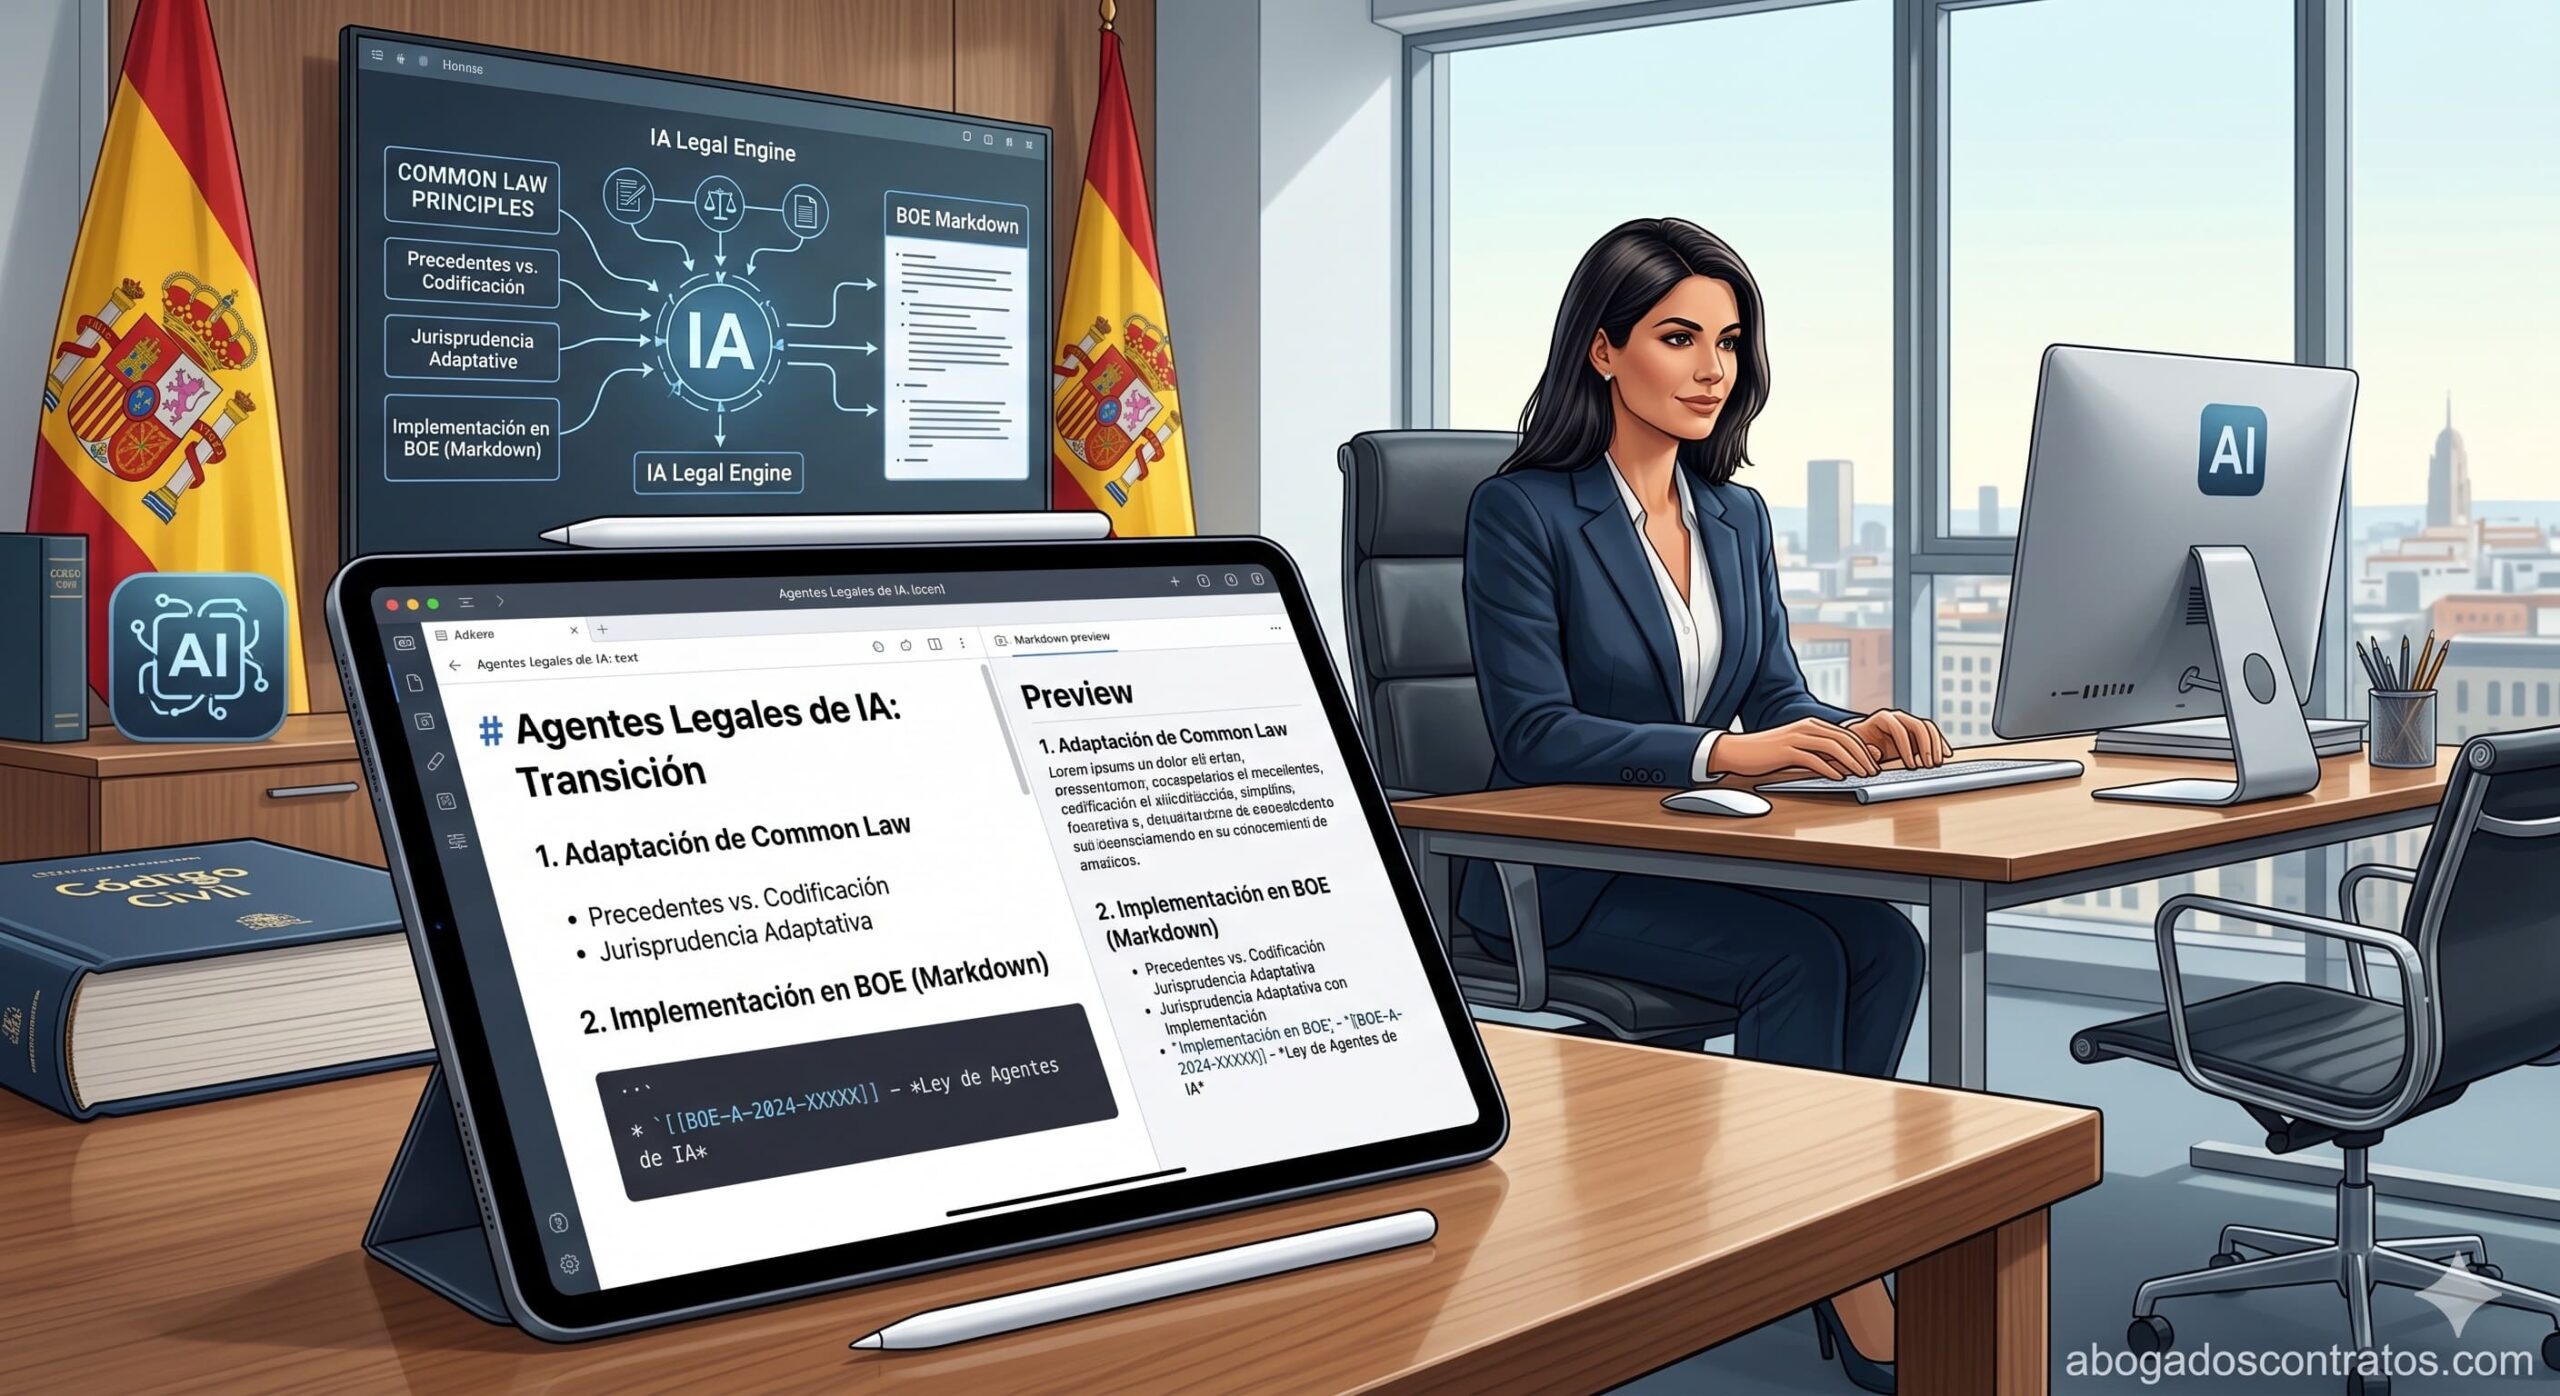
  • Agentes legales de IA para España: del common law al BOE en Markdown

    Agentes legales de IA para España: del common law al BOE en Markdown

    La inteligencia artificial jurídica empieza a moverse por una vía distinta a la de los grandes productos cerrados. Anthropic ha publicado un repositorio open source con agentes, skills y conectores pensados para flujos legales, desde revisión contractual y privacidad hasta litigios, propiedad intelectual, gobierno de IA y formación jurídica. La idea es potente, pero arrastra un problema evidente para cualquier despacho español: el derecho no es universal, y una arquitectura pensada para el entorno anglosajón no resuelve por sí sola las necesidades de quien trabaja con el Estatuto de los Trabajadores, la Ley de Enjuiciamiento Civil, la Ley Concursal, la LOPDGDD o el BOE.

    Ese hueco es el que intenta cubrir claude-para-abogados, una adaptación al ordenamiento español del repositorio original de Anthropic. El proyecto, publicado en GitHub, declara 20 módulos, 100 skills y 17 agentes programados, con áreas que van de mercantil, societario y laboral a fiscal, administrativo, inmobiliario, concursal, familia, protección de datos, startups, clínica jurídica y estudiantes de Derecho. Su planteamiento no es vender una herramienta terminada, sino abrir una base sobre la que abogados, tecnólogos jurídicos y despachos puedan probar, corregir y mejorar.

    La clave no está solo en traducir comandos. Está en adaptar la lógica de trabajo al contexto español. Un abogado laboralista no necesita que el agente le pregunte por discovery o por criterios propios del common law. Necesita que entienda convenios colectivos, tipos de despido, cálculo de indemnizaciones, plazos, documentación laboral y criterios de revisión humana. Un procesalista necesita LEC, plazos, cronologías, escritos, requerimientos y control del riesgo procesal. Un equipo de privacidad necesita RGPD, LOPDGDD, AEPD, encargos de tratamiento, EIPD y brechas de seguridad.

    Del plugin genérico al despacho configurable

    Uno de los elementos más interesantes del proyecto es el uso de entrevistas iniciales. Cada módulo puede configurar un perfil de práctica, con información sobre jurisdicción, comunidad autónoma, tipo de despacho, estilo de trabajo y criterios internos. Esto permite que las skills no operen en abstracto, sino dentro de un contexto profesional definido por el usuario.

    El repositorio mantiene la arquitectura original de Anthropic: plugins, perfiles de práctica, cold-start interviews, skills, agentes programados y conectores. La adaptación española añade áreas propias y comandos pensados para flujos jurídicos reales en España. En laboral, por ejemplo, aparecen revisión de despidos, revisión de contratación, clasificación de relación laboral, redacción de políticas, cálculo de indemnizaciones y consultas rápidas. En societario, se incluyen revisión de due diligence, extracción de incidencias, acuerdos sociales, cumplimiento registral y checklist de cierre. En procesal, cronologías, demandas, plazos, intake de asunto y briefing.

    ÁreaEjemplos de agentes o skillsValor práctico
    MercantilRevisión de contratos, NDAs, adendas, renovacionesEstandarizar revisión y detectar desviaciones del playbook
    LaboralDespidos, contratación, falso autónomo, indemnizacionesApoyo previo a revisión profesional y control de requisitos
    ProcesalCronologías, demandas, plazos, intake, portfolioOrdenar hechos, vencimientos y documentación
    Privacidad y protección de datosDerechos ARCO-POL, EIPD, brechas, AEPDMejorar respuesta y documentación de cumplimiento
    FiscalCalendario AEAT, declaraciones, consultas, procedimientosOrganizar obligaciones y revisar coherencia
    AdministrativoProcedimientos, contratación pública, contenciosoApoyo en plazos, recursos y pliegos
    StartupsSL, pacto de socios, stock options, rondas, incentivosAcompañar operaciones frecuentes en empresas jóvenes
    EstudiantesMétodo socrático, IRAC, oposiciones, fichasUso formativo sin sustituir el estudio jurídico

    La tabla muestra por qué este tipo de repositorios puede ser relevante. No se trata de crear “un abogado IA” que responda cualquier cosa, sino de encapsular tareas repetibles, entrevistas guiadas, checklists y flujos de trabajo que el profesional puede adaptar. Ese enfoque reduce el riesgo de respuestas genéricas y obliga a trabajar con contexto.

    La base de conocimiento importa tanto como el agente

    El gran cuello de botella de la IA jurídica no es solo el modelo. Es el dato. Un agente puede tener una arquitectura excelente, pero si no accede a fuentes normativas actualizadas, jurisprudencia fiable y documentos internos bien organizados, su utilidad será limitada. Por eso el proyecto apunta a conectores MCP como BOE, CENDOJ, EUR-Lex, AEPD, Registro Mercantil, OEPM, EUIPO, DGT, PLACE, LexNET, Registro Público Concursal, Catastro o CGPJ. Muchos de esos conectores todavía no existen en el repositorio, pero están identificados como piezas de alto valor.

    Aquí encaja otro movimiento relevante: la legislación española empieza a estar disponible en formatos más amigables para máquinas. El proyecto legalize-es, por ejemplo, publica legislación española como repositorio Git, con leyes en archivos Markdown y reformas registradas como commits. Su página en GitHub lo describe como un repositorio con más de 8.600 leyes y una lógica pensada para que cada norma pueda leerse, versionarse y compararse como código.

    Esta idea cambia la conversación. Durante años, buena parte de la legaltech española ha dependido de bases de datos cerradas, buscadores propietarios y PDFs difíciles de procesar. Si la legislación, los boletines y las normas consolidadas se convierten en corpus legibles por máquinas, los agentes legales pueden trabajar con más contexto, trazabilidad y capacidad de actualización. El usuario menciona también repositorios de boletines del BOE en Markdown, tanto actuales como históricos, que podrían reforzar esa línea si se integran con conectores y procesos de validación.

    Pero la disponibilidad de textos legales no resuelve todos los problemas. El derecho no es una suma de artículos. Importa la interpretación, la jerarquía normativa, la vigencia, la jurisprudencia, la doctrina administrativa, los criterios autonómicos, el caso concreto y el riesgo profesional. Un agente puede ayudar a preparar un borrador, ordenar hechos o sugerir una ruta de análisis, pero no debe presentarse como una conclusión jurídica final.

    El aviso necesario: no está listo para usarse sin abogado

    El propio repositorio lo deja claro: no ha sido testado con casos reales y puede contener errores, omisiones o interpretaciones incorrectas. También insiste en que todo resultado requiere revisión humana por un profesional cualificado, pensamiento crítico y criterio profesional. No constituye asesoramiento jurídico ni sustituye a un abogado colegiado.

    Ese descargo no es una formalidad. En derecho, una alucinación no es solo una respuesta mala; puede ser un plazo perdido, una cláusula peligrosa, una referencia normativa falsa o una decisión procesal equivocada. Por eso la mejor forma de entender estos agentes es como asistentes de trabajo, no como sistemas autónomos de decisión.

    La oportunidad, aun así, es clara. La IA permite adaptar herramientas legales a jurisdicciones concretas con una velocidad que antes era impensable. Hace unos años, una solución nacida en Estados Unidos podía tardar mucho en llegar al mercado español, si llegaba. Ahora un desarrollador o un despacho con conocimiento técnico puede tomar una arquitectura open source, traducirla, reordenarla y conectarla con fuentes locales.

    Eso desplaza la barrera. Ya no es solo tecnológica. Es profesional y organizativa. ¿Quién valida las skills? ¿Quién revisa referencias? ¿Quién mantiene la actualización normativa? ¿Qué despacho se atreve a probar con casos no críticos? ¿Cómo se documenta el uso de IA ante un cliente? ¿Qué límites se fijan para evitar que un borrador se confunda con un dictamen?

    Los despachos españoles no tienen por qué adoptar agentes legales mañana, pero sí deberían empezar a entender cómo funcionan. La ventaja no estará en usar IA para redactar más rápido cualquier texto, sino en diseñar flujos seguros: intake de cliente, revisión inicial de contratos, detección de riesgos, cronologías, clasificación documental, preparación de reuniones, control de plazos y vigilancia normativa.

    claude-para-abogados es todavía un punto de partida. Precisamente por eso resulta interesante. No intenta cerrar el mercado ni prometer una revolución inmediata. Propone una base abierta para que quienes conocen el derecho español la prueben, la rompan y la mejoren. En legaltech, esa puede ser una de las señales más relevantes de la nueva etapa: las herramientas ya no tienen que llegar siempre desde fuera, en inglés y para otro sistema jurídico. También pueden nacer desde repositorios abiertos, legislación en Markdown y abogados dispuestos a trabajar con máquinas sin delegarles el criterio.

    Preguntas frecuentes

    ¿Qué es claude-para-abogados?
    Es una adaptación open source al derecho español del repositorio claude-for-legal de Anthropic, con módulos, skills y agentes para flujos jurídicos habituales en España.

    ¿Puede sustituir a un abogado?
    No. El propio proyecto advierte de que no ha sido testado con casos reales y que cualquier resultado debe ser revisado por un profesional cualificado.

    ¿Qué áreas jurídicas cubre?
    Incluye mercantil, societario, laboral, propiedad intelectual, procesal, privacidad, consumo, regulatorio, gobernanza de IA, fiscal, administrativo, inmobiliario, concursal, familia, protección de datos, startups, clínica jurídica y estudiantes de Derecho.

    ¿Por qué importa que la legislación esté en Markdown?
    Porque facilita que los sistemas de IA, buscadores, agentes y herramientas de análisis trabajen con normas más estructuradas, versionables y legibles por máquinas.

    vía: LinkedIN

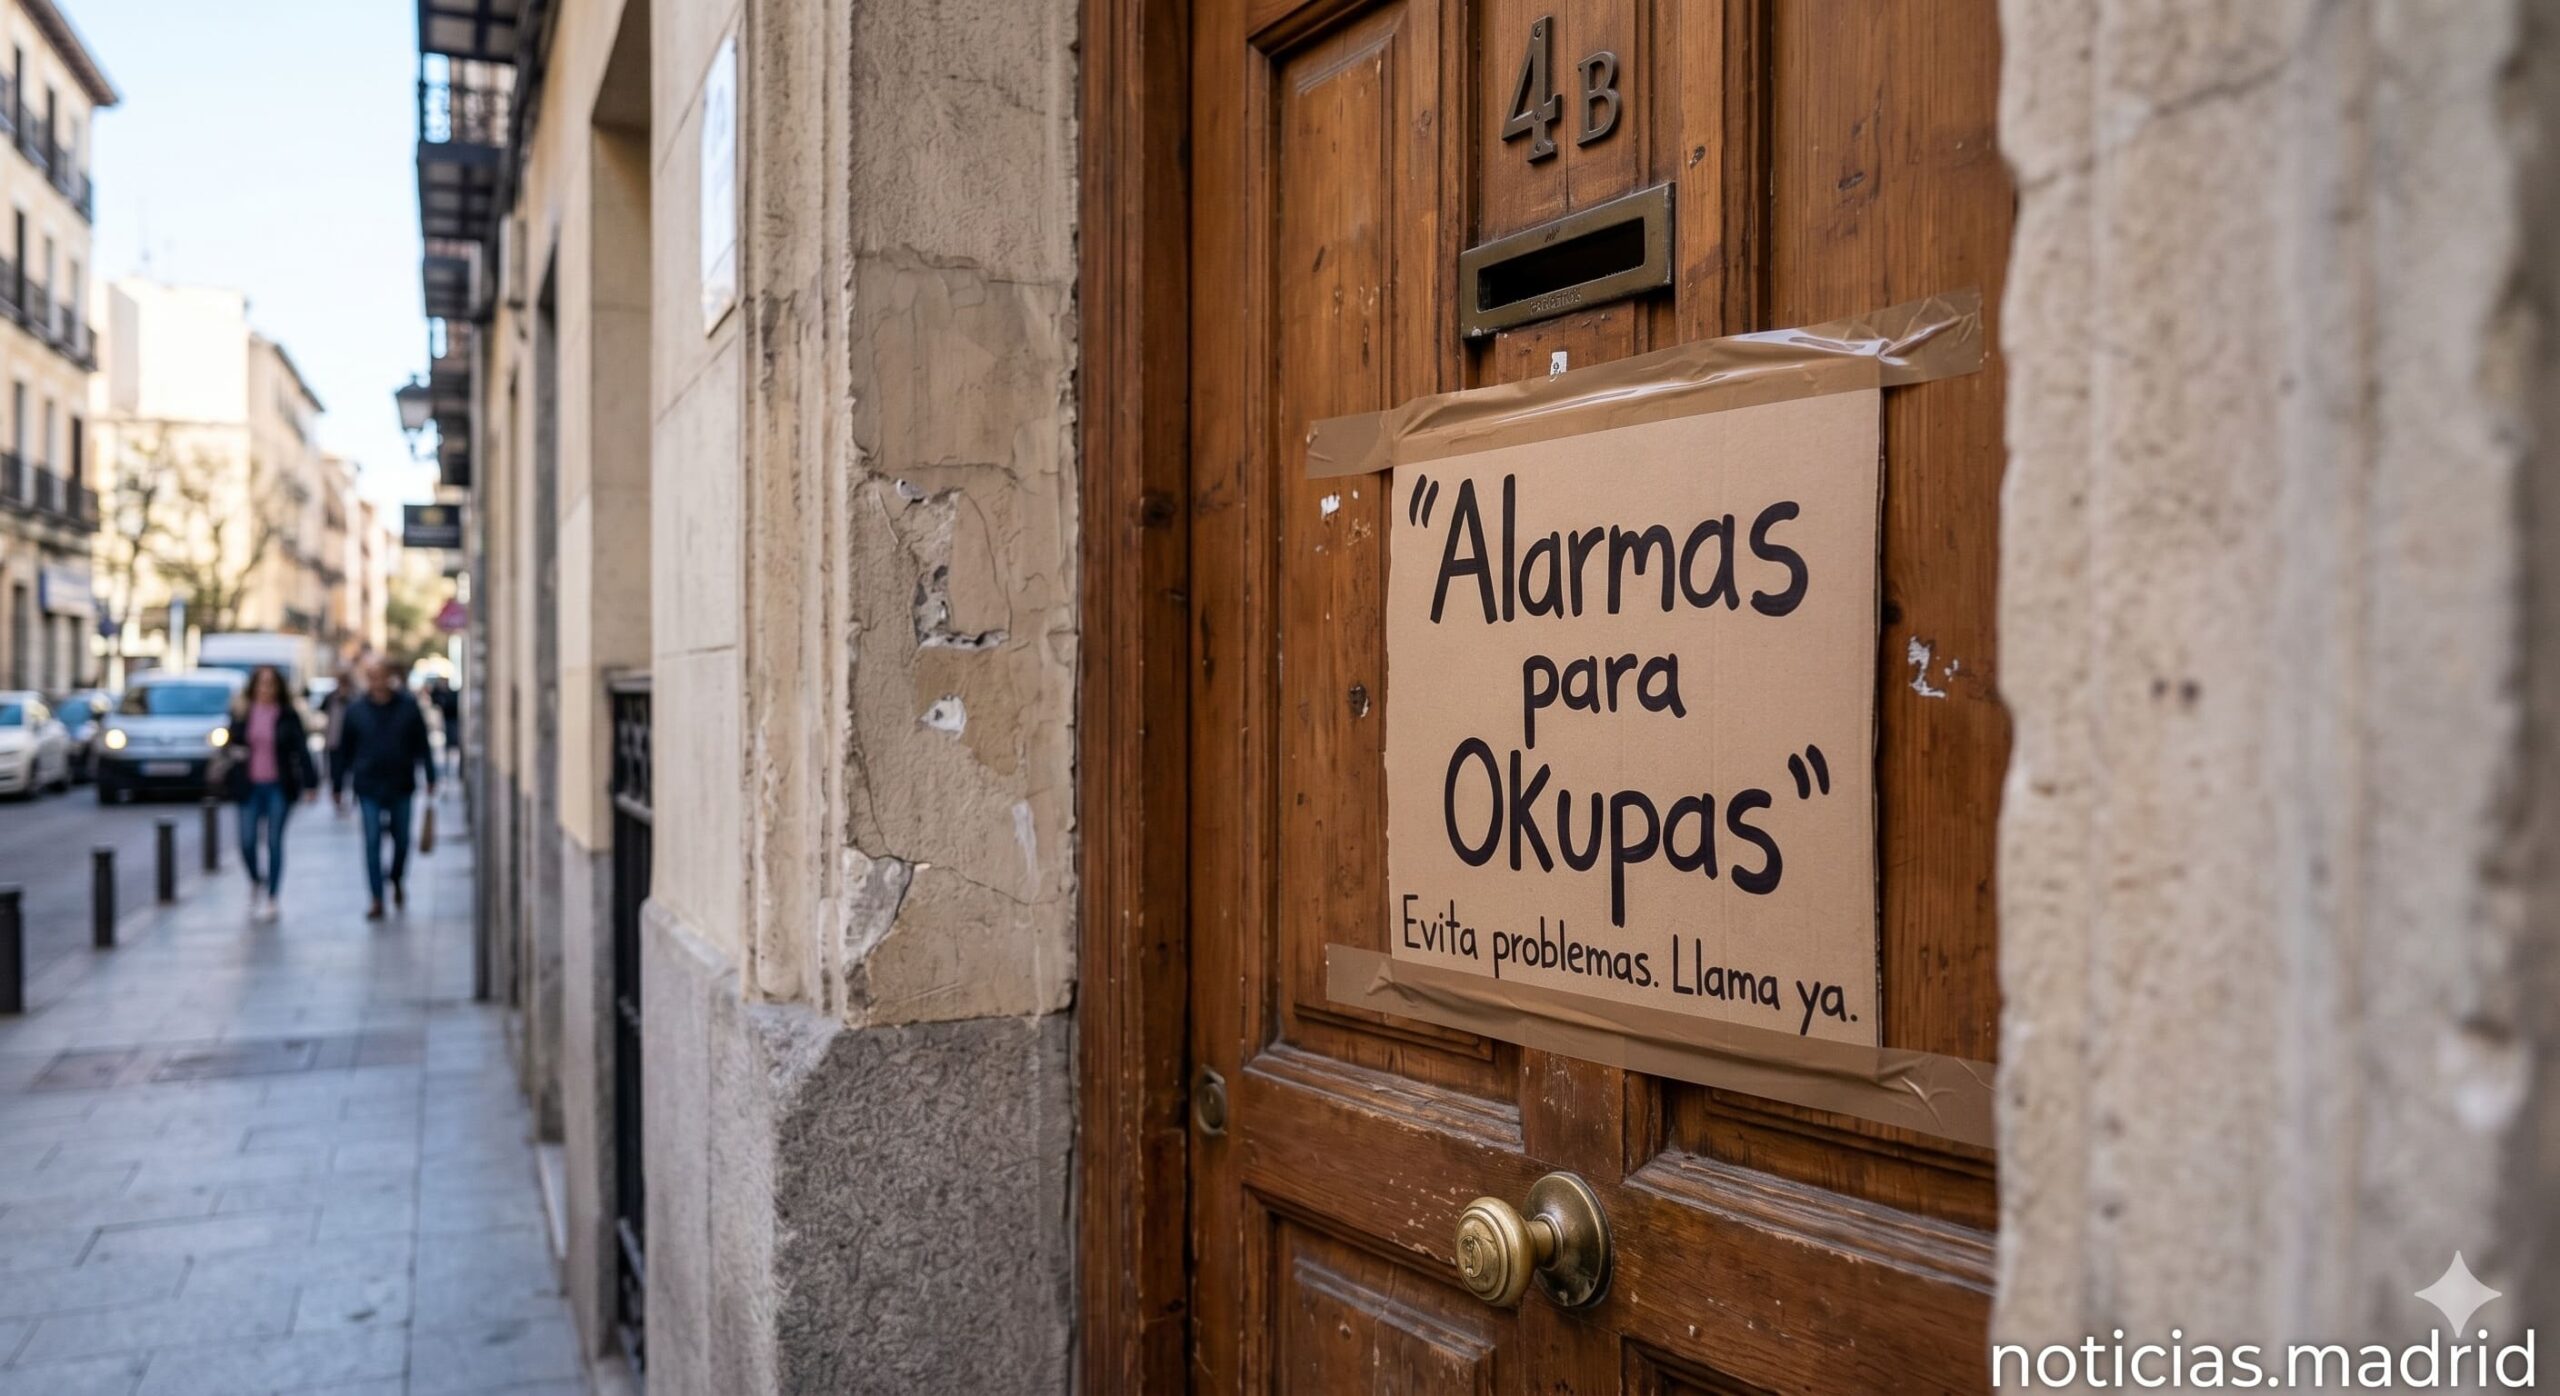
  • “Alarmas para okupas”: el vacío legal que deberían cerrar las empresas de seguridad

    “Alarmas para okupas”: el vacío legal que deberían cerrar las empresas de seguridad

    El intento de ocupación de varios pisos de obra nueva en Chamberí, evitado según publicó Noticias Madrid por la rápida actuación de vecinos, promotora y Policía Municipal, ha vuelto a poner sobre la mesa un problema que no encaja bien en el debate habitual sobre vivienda: qué ocurre cuando una persona entra sin título legítimo en un inmueble y consigue contratar una alarma como si fuera su domicilio.

    La expresión “alarmas para okupas” es dura, pero refleja una inquietud real entre propietarios y compradores. No se trata de afirmar que las empresas de seguridad faciliten ocupaciones ilegales de forma consciente, ni de señalar sin pruebas a una compañía concreta. Pero sí existe una pregunta jurídica y de cumplimiento que el sector debería responder con claridad: ¿qué verificaciones se hacen antes de instalar una alarma conectada a una central receptora en una vivienda?

    La Ley de Seguridad Privada regula, entre otras actividades, la instalación y mantenimiento de sistemas de seguridad conectados a centrales receptoras de alarmas o centros de control. Es decir, no hablamos de una simple venta doméstica sin trascendencia. Una alarma conectada puede activar avisos, movilizar servicios, generar registros y contribuir a crear una apariencia de posesión sobre un inmueble. Si quien la contrata no es propietario, arrendatario ni autorizado por el titular, el riesgo para terceros es evidente.

    El problema legal: apariencia de posesión y perjuicio al propietario

    Una alarma no otorga derechos sobre una vivienda. No convierte al ocupante en dueño ni en inquilino. Pero en la práctica puede complicar una situación que ya es difícil. Una entrada no autorizada reciente puede resolverse con mayor rapidez si se acredita de inmediato la titularidad o posesión legítima. En cambio, cuando pasan las horas y quien está dentro cambia cerraduras, introduce enseres, conecta suministros o instala una alarma, el conflicto puede adquirir una apariencia de normalidad que obliga al propietario a recorrer un camino más largo.

    La Ley de Enjuiciamiento Civil prevé mecanismos para recuperar la posesión de una vivienda ocupada sin consentimiento, incluido el procedimiento del artículo 441.1 bis, que permite requerir al ocupante para que aporte título que justifique su situación posesoria. Si no lo hace en plazo, el juez puede acordar la entrega inmediata de la posesión al demandante en determinados supuestos. Pero incluso las vías rápidas exigen tiempo, documentación, abogado, procurador y capacidad de reacción.

    Desde el punto de vista de responsabilidad civil y cumplimiento, la pregunta no es si la empresa de alarmas debe resolver el conflicto posesorio. No debe hacerlo. La pregunta es si puede limitarse a creer sin más a quien solicita la instalación. En un mercado con fuerte presión comercial, cuotas mensuales y permanencias de varios años, existe el riesgo de que el incentivo por cerrar contratos pese más que la comprobación documental del derecho de uso.

    Ese riesgo afecta a todo el sector, incluidas grandes marcas como Verisure o Securitas Direct, y también a operadores medianos y locales. La cuestión no debería plantearse como una acusación individual, sino como una mejora necesaria del estándar de diligencia. Quien instala un sistema de seguridad en una vivienda debe estar en condiciones de demostrar que comprobó, con medios razonables, que el solicitante podía contratarlo.

    Qué podrían hacer de verdad las empresas de alarmas

    El sector tiene margen para actuar sin esperar a una reforma legal. Muchas medidas son de puro cumplimiento interno, trazabilidad y control de riesgos. Algunas podrían incluso convertirse en estándar sectorial o exigencia normativa.

    1. Verificación documental obligatoria del derecho de uso. Antes de instalar una alarma en una vivienda, la empresa debería exigir escritura, nota simple reciente, contrato de arrendamiento, autorización firmada del titular o documento equivalente. La simple manifestación verbal del cliente no debería bastar.
    2. Bloqueo automático de instalaciones sin documentación suficiente. Si el solicitante no acredita propiedad, alquiler o autorización, el expediente debería quedar suspendido. No se trata de prejuzgar una ocupación, sino de no instalar un sistema sensible sin base documental mínima.
    3. Protocolo reforzado para viviendas vacías, obra nueva o inmuebles sin suministros ordinarios. Estos casos tienen más riesgo. Si la vivienda es de obra nueva, está sin amueblar, no hay contrato de suministro regular o el solicitante no puede acreditar relación previa con el inmueble, debería activarse una revisión manual de cumplimiento.
    4. Canal urgente para propietarios que detecten una alarma contratada por terceros. Las empresas deberían habilitar un procedimiento rápido para que el titular pueda comunicar que se ha instalado o solicitado una alarma en su vivienda sin autorización. Ese canal debería permitir aportar escritura, denuncia, nota simple o documentación de la promotora.
    5. Suspensión cautelar del servicio en casos documentados de conflicto de titularidad. Cuando el propietario aporte indicios sólidos de contratación irregular, la empresa debería revisar el caso de inmediato y, si procede, suspender o limitar el servicio hasta aclarar la situación, siempre respetando la normativa aplicable y evitando actuaciones que pongan en riesgo a personas.
    6. Auditoría interna de contrataciones de riesgo. Las compañías deberían revisar periódicamente altas en inmuebles con señales atípicas: instalación urgente, negativa a aportar documentos, direcciones de promociones recién terminadas, viviendas sin historial previo o discrepancias entre datos del solicitante y datos del inmueble.
    7. Trazabilidad completa del expediente comercial. Conversaciones, documentación recibida, identidad del contratante, dirección exacta, técnico instalador, fecha, hora y comprobaciones realizadas deberían quedar registradas. Si después hay un conflicto, esa trazabilidad protege al propietario, a la empresa y al propio sistema.
    8. Formación específica a comerciales y técnicos. El equipo de ventas no debería tratar estos contratos como una alta ordinaria. Debe saber detectar señales de alerta: prisas injustificadas, ausencia de documentación, contradicciones sobre la titularidad, negativa a facilitar datos o solicitudes en viviendas aparentemente vacías.
    9. Cooperación con Fuerzas y Cuerpos de Seguridad. Cuando haya denuncia o indicios de ocupación, la empresa debe contar con un protocolo claro de colaboración, dentro de los límites legales y de protección de datos. La seguridad privada no puede sustituir a la Policía, pero tampoco puede actuar de espaldas a ella.
    10. Cláusula contractual expresa sobre falsedad documental o falta de título. El contrato debería advertir de que la declaración falsa sobre la posesión o autorización de uso puede dar lugar a resolución inmediata del servicio y a comunicación a las autoridades cuando proceda.

    Estas medidas no impedirían todas las ocupaciones, pero sí cerrarían una vía de consolidación aparente. También protegerían a las propias empresas frente a reclamaciones, daño reputacional y posibles conflictos civiles. En un sector que vende confianza, la diligencia documental debería ser parte del producto.

    Una reforma posible sin convertir a las alarmas en jueces

    Regular mejor no significa exigir a las empresas de alarmas que resuelvan disputas de propiedad. No son jueces ni registradores. Pero sí puede imponerse una obligación mínima de comprobación razonable, igual que ocurre en otros sectores donde una contratación puede afectar a terceros o facilitar abusos.

    El legislador podría estudiar una modificación normativa o una instrucción sectorial que establezca requisitos claros para contratar alarmas conectadas a centrales receptoras en viviendas: identificación reforzada del cliente, acreditación del derecho de uso, conservación de documentos, protocolo ante reclamación del titular y comunicación con autoridades en supuestos de denuncia.

    También sería útil coordinar estos controles con promotoras, administradores de fincas y comunidades de propietarios. En el caso de Chamberí, la actuación rápida evitó que los intentos de ocupación avanzaran. Pero si una vivienda de obra nueva llega a ser ocupada y el ocupante contrata una alarma en cuestión de horas, el problema deja de ser solo policial y pasa a ser jurídico, comercial y regulatorio.

    España no necesita convertir cada trámite en una carga imposible. Pero tampoco puede permitir que un servicio diseñado para proteger hogares termine, por falta de verificación, reforzando la posición de quien no tiene derecho a estar en ellos. La seguridad privada debe ser parte de la solución, no un elemento que añada confusión al propietario legítimo.

    La ocupación ilegal es un fenómeno complejo y no se resuelve con una sola medida. Pero hay reformas de sentido común que pueden reducir daños. Una de ellas es exigir que, antes de instalar una alarma en una vivienda, se compruebe algo tan básico como quién tiene derecho a contratarla.

    Preguntas frecuentes

    ¿Una empresa de alarmas está obligada a comprobar la propiedad de una vivienda?
    La normativa regula la actividad de seguridad privada, pero el debate está en reforzar de forma expresa la verificación documental del derecho de uso antes de instalar alarmas en viviendas.

    ¿Puede una alarma ayudar a consolidar una ocupación ilegal?
    No concede derechos, pero puede crear apariencia de control sobre el inmueble y complicar la respuesta inicial del propietario si se suma a otros indicios como cambio de cerradura o suministros.

    ¿Qué documentación debería pedirse antes de instalar una alarma?
    Escritura, nota simple, contrato de alquiler, autorización del propietario o documentación equivalente que acredite una relación legítima con la vivienda.

    ¿Qué puede hacer un propietario si detecta una alarma contratada sin permiso en su casa?
    Debe denunciar de inmediato, acreditar titularidad o posesión legítima, contactar con la empresa de alarmas por escrito y solicitar revisión urgente del contrato, además de pedir asesoramiento legal.

  • La UE aplaza obligaciones clave del AI Act y abre una nueva agenda legal

    La UE aplaza obligaciones clave del AI Act y abre una nueva agenda legal

    La Unión Europea ha pactado una modificación relevante del calendario y de algunas obligaciones de la Ley de Inteligencia Artificial. El acuerdo provisional alcanzado entre la presidencia del Consejo y los negociadores del Parlamento Europeo forma parte del paquete Omnibus VII, una iniciativa de simplificación normativa que busca reducir cargas administrativas y aclarar la aplicación del marco digital europeo sin desmontar la arquitectura básica del AI Act.

    Para despachos, asesorías jurídicas, departamentos de compliance y equipos de protección de datos, el mensaje es claro: no se elimina el cumplimiento, se reorganiza. La novedad más visible es el retraso de las obligaciones para sistemas de IA de alto riesgo, pero el acuerdo también introduce una nueva prohibición sobre contenido sexual o íntimo no consentido generado con IA, ajusta registros, matiza el tratamiento de datos sensibles para detectar sesgos y aborda solapamientos con normativa sectorial en productos como maquinaria, dispositivos médicos, juguetes, ascensores o embarcaciones.

    Nuevas fechas para los sistemas de alto riesgo

    El cambio central está en el calendario. Las obligaciones para sistemas de IA de alto riesgo ya no se aplicarían de forma general desde el 2 de agosto de 2026. El acuerdo provisional fija dos nuevas fechas: 2 de diciembre de 2027 para sistemas de alto riesgo independientes y 2 de agosto de 2028 para sistemas de alto riesgo integrados en productos. El Consejo explica que esta solución busca dar tiempo a que estén disponibles estándares, herramientas y orientaciones necesarias para aplicar la norma de forma más armonizada.

    Para el sector legal, este retraso cambia la planificación de cumplimiento, pero no debería interpretarse como una pausa total. Las empresas que desarrollan, compran o integran IA deberán seguir trabajando en inventarios, clasificación de sistemas, contratos con proveedores, documentación técnica, evaluación de riesgos, trazabilidad, supervisión humana y gobernanza de datos. La ventaja es que ahora existe más margen para hacerlo con estándares más definidos y menos riesgo de rediseños posteriores.

    MateriaSituación tras el acuerdo provisional
    Sistemas IA de alto riesgo independientesNueva fecha prevista: 2 de diciembre de 2027
    Sistemas IA de alto riesgo integrados en productosNueva fecha prevista: 2 de agosto de 2028
    Sandboxes regulatorios nacionalesPlazo aplazado hasta el 2 de agosto de 2027
    Transparencia para contenido generado artificialmenteNuevo plazo: 2 de diciembre de 2026
    Registro en base de datos europeaSe restablece para determinados sistemas que aleguen exención de alto riesgo
    Contenido íntimo no consentido y CSAMNueva práctica prohibida incorporada al AI Act

    El aplazamiento también reduce una presión práctica: muchas compañías todavía no tienen claro si determinados sistemas entran o no en la categoría de alto riesgo, sobre todo cuando la IA se integra en productos regulados o en procesos internos de decisión. Los asesores legales tendrán que acompañar esa clasificación con criterios documentados, porque el hecho de que una obligación se retrase no elimina la necesidad de dejar constancia de por qué se considera que un sistema está dentro o fuera de una categoría determinada.

    La nueva prohibición: contenido íntimo no consentido y menores

    El acuerdo añade una prohibición expresa de prácticas de IA relacionadas con la generación de contenido sexual o íntimo no consentido y material de abuso sexual infantil. La Comisión Europea presentó este punto como una respuesta a riesgos ya visibles en herramientas capaces de crear o manipular imágenes mediante IA generativa, incluidas las conocidas aplicaciones de “nudificación”.

    Desde la perspectiva jurídica, esta incorporación refuerza un frente que ya combinaba derecho penal, protección de datos, derechos fundamentales, responsabilidad civil, protección de menores y regulación de plataformas. La novedad es que el AI Act incorpora el riesgo dentro de su catálogo de prácticas prohibidas, lo que puede facilitar acciones regulatorias específicas contra proveedores o distribuidores de sistemas diseñados para esos usos.

    El reto estará en definir bien el alcance. Algunos análisis jurídicos ya señalan que harán falta guías de la Comisión para delimitar qué sistemas quedan cubiertos, cómo se tratan herramientas de generación o edición de imagen con usos legítimos y cuándo una capacidad general se convierte en una práctica prohibida por su diseño, comercialización o uso previsto.

    Para abogados especializados en tecnología, penal económico o derechos digitales, este punto puede abrir una nueva línea de asesoramiento: términos de uso de plataformas generativas, mecanismos de denuncia, moderación, trazabilidad de contenidos, conservación de pruebas, deberes de retirada, responsabilidad de desarrolladores y coordinación con normas nacionales sobre violencia digital y protección de menores.

    Datos sensibles, sesgos y registro: más trabajo para compliance

    El acuerdo también restablece el estándar de “estricta necesidad” para el tratamiento de categorías especiales de datos personales cuando se usen para detectar y corregir sesgos. Es un punto delicado porque muchas organizaciones necesitan analizar variables sensibles para comprobar si un sistema discrimina, pero al mismo tiempo deben respetar límites estrictos del RGPD.

    La cuestión práctica será cómo justificar ese tratamiento. Los equipos jurídicos tendrán que revisar bases legales, minimización de datos, controles de acceso, seudonimización, conservación, evaluación de impacto y documentación interna. En sectores como empleo, crédito, educación, seguros o servicios públicos, el equilibrio entre corregir sesgos y no ampliar de forma indebida el tratamiento de datos sensibles será especialmente exigente.

    Otro punto relevante es la obligación de registro en la base de datos europea para sistemas en los que el proveedor considere aplicable una exención de la clasificación de alto riesgo. Esto reduce el margen para decisiones opacas. Si una compañía sostiene que su sistema no debe tratarse como alto riesgo, probablemente tendrá que documentar mejor su razonamiento y asumir que esa decisión puede ser revisada.

    Para los despachos, esta obligación abre un trabajo muy concreto: matrices de clasificación, memorandos justificativos, políticas internas de revisión, cláusulas contractuales con proveedores y procedimientos de actualización cuando cambie el uso del sistema o se incorpore una nueva funcionalidad.

    Normativa sectorial y maquinaria: el problema del solapamiento

    El acuerdo provisional aborda uno de los asuntos más complejos del AI Act: su interacción con legislación sectorial armonizada. En productos regulados, como dispositivos médicos, juguetes, ascensores, maquinaria o embarcaciones, existía el riesgo de duplicar requisitos de seguridad y conformidad.

    La solución pactada introduce un mecanismo para limitar la aplicación directa de determinadas exigencias del AI Act cuando la normativa sectorial ya incluya requisitos específicos equivalentes. En maquinaria, se opta por excluir la aplicabilidad directa del AI Act y permitir que la Comisión adopte actos delegados bajo el Reglamento de Máquinas para añadir requisitos de salud y seguridad relativos a sistemas de IA de alto riesgo. El Consejo presenta esta solución como una forma de evitar solapamientos y reducir carga de cumplimiento.

    Este punto será especialmente relevante para fabricantes industriales, importadores, distribuidores y organismos notificados. La pregunta ya no será solo si un sistema es de alto riesgo, sino bajo qué régimen debe demostrarse la conformidad y qué autoridad resulta competente. En la práctica, muchas compañías necesitarán mapas normativos que conecten AI Act, RGPD, ciberseguridad, seguridad de producto, responsabilidad por productos defectuosos y regulación sectorial.

    Un respiro, no una exención

    El acuerdo todavía debe ser respaldado formalmente por el Consejo y el Parlamento Europeo y pasar por revisión jurídico-lingüística antes de su adopción definitiva. Por tanto, los equipos legales deben tratarlo como una base de planificación muy relevante, pero no como texto final plenamente cerrado.

    Aun así, la dirección política es clara. Bruselas quiere rebajar complejidad administrativa, ofrecer más seguridad jurídica y evitar que la falta de estándares convierta el cumplimiento en una carrera incierta. Al mismo tiempo, refuerza prohibiciones frente a abusos concretos de la IA generativa y mantiene elementos de trazabilidad y supervisión.

    Para los abogados, el trabajo no se reduce; cambia de ritmo. Habrá más tiempo para preparar a los clientes, pero también más expectativa de que esa preparación sea seria. Las empresas que esperen al último semestre antes de la entrada en vigor de las obligaciones de alto riesgo se encontrarán con inventarios incompletos, contratos desactualizados y sistemas ya desplegados sin documentación suficiente.

    El AI Act entra así en una fase más jurídica que política. La pregunta deja de ser si Europa regulará la IA. Ya lo ha hecho. La cuestión ahora es cómo se traduce esa regulación en contratos, evaluaciones de impacto, matrices de riesgo, políticas internas, auditorías, expedientes técnicos, cláusulas de compra, responsabilidad de proveedores y mecanismos de supervisión.

    Preguntas frecuentes

    ¿El acuerdo retrasa toda la Ley de IA europea?
    No. El retraso afecta principalmente a determinadas obligaciones sobre sistemas de IA de alto riesgo. Otras partes del AI Act siguen su propio calendario de aplicación.

    ¿Cuáles son las nuevas fechas clave para sistemas de alto riesgo?
    El acuerdo provisional fija el 2 de diciembre de 2027 para sistemas de alto riesgo independientes y el 2 de agosto de 2028 para sistemas de alto riesgo integrados en productos.

    ¿Qué cambia para los abogados de empresa?
    Deberán revisar clasificación de sistemas, contratos con proveedores, documentación técnica, protección de datos, registros, tratamiento de sesgos y posibles solapamientos con normativa sectorial.

    ¿La nueva prohibición sobre contenido íntimo afecta solo a plataformas grandes?
    No necesariamente. Puede afectar a desarrolladores, proveedores, distribuidores o integradores de sistemas de IA capaces de generar o facilitar contenido sexual o íntimo no consentido o material de abuso sexual infantil.

    vía: Noticias inteligencia artificial

  • Google y Bruselas chocan por la privacidad de las búsquedas en plena carrera de la IA

    Google y Bruselas chocan por la privacidad de las búsquedas en plena carrera de la IA

    Google ha elevado el tono contra la Comisión Europea por una de las medidas más delicadas del Reglamento de Mercados Digitales: la obligación de compartir datos de búsqueda con terceros para favorecer la competencia. La compañía sostiene que la propuesta de Bruselas puede poner en riesgo la privacidad de los usuarios, incluso si los datos se entregan anonimizados.

    El debate va mucho más allá de una disputa entre Google y sus rivales. Lo que está en juego es si la Unión Europea puede obligar a una plataforma dominante a abrir parte de sus datos sin crear una nueva fuente de riesgo para millones de personas. En una época en la que los asistentes de Inteligencia Artificial empiezan a competir con los buscadores tradicionales, la respuesta tendrá consecuencias para Google, OpenAI, Bing, DuckDuckGo y cualquier empresa que quiera construir servicios de búsqueda o respuesta sobre datos reales de comportamiento.

    Qué quiere hacer la Unión Europea

    La Comisión Europea propuso en abril una serie de medidas preliminares para que Google comparta con terceros datos de su buscador, como información de ranking, consultas, clics y visualizaciones. La base legal está en el Reglamento de Mercados Digitales, que impone obligaciones especiales a grandes plataformas consideradas “guardianes de acceso”.

    La idea de Bruselas es sencilla sobre el papel: si Google domina el mercado de búsquedas, sus competidores necesitan acceder a datos que les permitan mejorar sus propios servicios. Un buscador, o un asistente de IA con funciones de búsqueda, aprende mucho de qué consulta el usuario, qué resultados se muestran, cuáles se abren y cómo se refina una búsqueda. Sin esa señal, competir contra Google resulta mucho más difícil.

    La Comisión no plantea entregar datos sin filtros. Sus propuestas incluyen eliminar identificadores directos, como cuentas o direcciones IP, suprimir consultas largas o raras que puedan facilitar la identificación, generalizar metadatos de ubicación o dispositivo, limitar información de sesión, imponer cifrado, prohibir la reidentificación y evitar la combinación con bases de datos auxiliares. También contempla auditorías independientes y un periodo de retención de 13 meses.

    Para Bruselas, este conjunto de salvaguardas permitiría equilibrar competencia y privacidad. Para Google, no basta.

    La advertencia de Google: anonimizar ya no garantiza anonimato

    Sergei Vassilvitskii, científico distinguido de Google y experto en privacidad diferencial, ha enviado una advertencia a los reguladores europeos. Según su posición, las técnicas modernas de análisis e Inteligencia Artificial pueden cruzar patrones aparentemente anónimos hasta reconstruir identidades concretas. El dato más llamativo es una prueba interna de la compañía: el equipo de Red Team de IA de Google habría logrado reidentificar usuarios en menos de dos horas a partir de datos anonimizados.

    La afirmación es potente porque cambia el centro del debate. El problema no sería solo si Google quiere o no compartir datos con competidores, sino si los mecanismos propuestos por la Comisión son técnicamente suficientes en 2026. Una consulta aislada puede parecer anónima. Un conjunto de consultas, clics, horarios, idioma, ubicación aproximada, dispositivo y patrones de navegación puede contar una historia mucho más precisa.

    Las búsquedas son una de las huellas digitales más sensibles que genera una persona. En ellas puede aparecer información sobre salud, trabajo, dinero, creencias, relaciones, dudas legales, problemas personales o intereses políticos. Aunque se eliminen nombres, cuentas e IP, ciertos patrones pueden ser únicos. Una búsqueda rara, combinada con una ubicación aproximada y una secuencia de clics, puede acercar mucho más de lo que parece a una persona real.

    Google tiene interés comercial en defender esta postura. Sus rivales lo recuerdan desde hace tiempo. Pero que el argumento beneficie a Google no significa que el riesgo sea inexistente. La historia de la privacidad digital está llena de ejemplos en los que datos supuestamente anonimizados acabaron siendo reidentificables al cruzarse con otras fuentes.

    Competencia, IA y una nueva batalla por los datos

    La disputa llega en un momento especialmente sensible. La búsqueda en Internet ya no se limita a una caja de texto con diez enlaces azules. Los usuarios empiezan a consultar a chatbots, asistentes de IA, navegadores con respuestas generadas y sistemas que combinan información web con razonamiento. En ese mercado, los datos de búsqueda son una materia prima muy valiosa.

    La Comisión quiere que terceros puedan acceder a esos datos si cumplen la definición aplicable de motor de búsqueda online. Esto podría incluir servicios tradicionales, pero también nuevas herramientas de IA que funcionen como puerta de entrada a la información. Reuters ha mencionado a OpenAI entre los posibles beneficiarios del acceso a datos, aunque el alcance final dependerá de cómo se definan las condiciones.

    Los competidores de Google llevan años acusando a la compañía de invocar la privacidad para proteger su posición dominante. DuckDuckGo, por ejemplo, pidió en 2024 nuevas investigaciones europeas sobre el cumplimiento de Google con el DMA y criticó que la propuesta de licenciar datos de búsqueda anonimizados era demasiado restrictiva y poco útil para competir. Desde esa óptica, Google estaría ofreciendo datos tan filtrados que no servirían realmente para mejorar servicios alternativos.

    Google responde que no puede comprometer la confianza de los usuarios ni entregar información que pueda convertirse en un mapa de comportamiento personal. El choque es difícil de resolver porque ambas posiciones tienen parte de razón. Sin acceso a datos, la competencia se debilita. Con demasiado acceso a datos, la privacidad puede quedar expuesta.

    El problema de fondo: regular datos sensibles en la era de la IA

    El caso muestra una tensión cada vez más habitual en Europa. La Unión Europea quiere abrir mercados digitales concentrados, limitar abusos de grandes plataformas y permitir que nuevos actores compitan en mejores condiciones. Pero muchos de los datos que dan ventaja a esas plataformas son precisamente los más sensibles.

    Antes, anonimizar podía parecer una solución razonable. Hoy resulta menos claro. Los modelos de IA, las técnicas estadísticas avanzadas y la disponibilidad de bases de datos auxiliares hacen que la frontera entre dato anónimo y dato reidentificable sea mucho más frágil. Una regulación pensada para compartir información debe asumir que los atacantes, o incluso competidores con incentivos comerciales fuertes, tendrán herramientas cada vez mejores para encontrar patrones.

    La Comisión intenta reducir ese riesgo con límites, auditorías y prohibiciones. La pregunta es si esos mecanismos serán suficientes y, sobre todo, quién responderá si no lo son. Si un tercero recibe datos de búsqueda anonimizados y logra vincularlos a personas concretas, el daño para el usuario puede ser difícil de reparar. Y si los datos se filtran, el problema ya no sería solo de competencia, sino de seguridad y derechos fundamentales.

    También hay una cuestión práctica. Cuanto más se protegen los datos, menos útiles pueden resultar para competir. Si se eliminan consultas raras, se agregan metadatos, se reduce la información de sesión y se impide cruzar fuentes, el dataset puede perder buena parte de su valor. Si se entregan datos más ricos, el riesgo aumenta. Ese equilibrio es el verdadero núcleo del conflicto.

    La decisión final de Bruselas será observada con atención por toda la industria. Si la Comisión mantiene una obligación amplia, Google probablemente intensificará su defensa técnica y legal. Si reduce mucho el alcance, los rivales dirán que el DMA se queda corto justo cuando la IA está redefiniendo el acceso a la información.

    La privacidad de las búsquedas no debería convertirse en una excusa automática para blindar monopolios, pero tampoco en un daño colateral de la competencia. La Unión Europea tiene razón al querer abrir mercados digitales cerrados. Google tiene razón al advertir que los datos de búsqueda son extremadamente sensibles. El reto está en no resolver un problema creando otro mayor.

    Preguntas frecuentes

    ¿Qué quiere obligar la Unión Europea a hacer a Google?
    La Comisión Europea propone que Google comparta con terceros datos de su buscador, como consultas, rankings, clics y visualizaciones, bajo condiciones justas, razonables y no discriminatorias.

    ¿Por qué Google dice que esto puede afectar a la privacidad?
    Google sostiene que, aunque se eliminen identificadores directos, los patrones de búsqueda pueden permitir reidentificar usuarios al cruzarse con otros datos y técnicas modernas de IA.

    ¿Qué datos de búsqueda pueden ser sensibles?
    Las búsquedas pueden revelar información sobre salud, finanzas, ubicación, trabajo, creencias, problemas legales, intereses personales o situación familiar. Por eso incluso datos anonimizados pueden ser delicados.

    ¿Quién podría beneficiarse de estos datos?
    Buscadores rivales y servicios de IA con funciones de búsqueda podrían usar esos datos para mejorar resultados, entrenar sistemas y competir mejor frente a Google, siempre que cumplan las condiciones que fije Bruselas.

    vía: elchapuzasinformatico

  • La AEPD avisa sobre la IA agéntica: ya no basta con vigilar el prompt

    La AEPD avisa sobre la IA agéntica: ya no basta con vigilar el prompt

    La inteligencia artificial agéntica empieza a llegar a empresas, despachos, departamentos de atención al cliente, áreas de recursos humanos, equipos comerciales y administraciones públicas con una promesa atractiva: sistemas capaces de planificar tareas, consultar herramientas, recordar contexto y actuar con distintos grados de autonomía. Pero esa misma capacidad de actuar es la que ha llevado a la Agencia Española de Protección de Datos a publicar unas orientaciones específicas sobre sus riesgos.

    La AEPD publicó el 18/02/2026 sus “Orientaciones sobre Inteligencia Artificial agéntica desde la perspectiva de protección de datos”, dirigidas a responsables y encargados que quieran utilizar agentes de IA en tratamientos de datos personales. El documento no pretende resolver casos concretos ni sustituir una evaluación jurídica específica, sino ayudar a entender cómo cambia el tratamiento cuando la IA deja de limitarse a responder y empieza a ejecutar pasos, usar memoria y conectarse con otros servicios.

    Qué entiende la AEPD por IA agéntica

    La Agencia define los agentes de IA como sistemas de inteligencia artificial que utilizan modelos de lenguaje para cumplir un objetivo. La diferencia frente a un chatbot convencional está en que el agente no se limita a contestar una pregunta aislada. Puede descomponer una tarea, decidir qué herramienta necesita, consultar datos, recordar información previa y actuar en varios pasos hasta alcanzar el resultado esperado.

    Esa autonomía introduce riesgos distintos. Un asistente que resume un texto puntual puede tratar datos personales durante unos segundos y devolver una respuesta. Un agente, en cambio, puede acceder a una base de datos, consultar un correo, recuperar información de una memoria persistente, generar una respuesta y enviarla automáticamente. El tratamiento ya no se explica solo por el modelo, sino por todo el sistema que lo rodea.

    La AEPD insiste en que no basta con conocer la herramienta “como usuario”. Las organizaciones deben comprender sus fundamentos, límites, alcance y forma de aplicación antes de incorporarla a tratamientos con datos personales. Rechazarla sin análisis puede hacer perder oportunidades de mejora; adoptarla sin control puede afectar a derechos y libertades de las personas.

    El enfoque es relevante porque desplaza el debate. La pregunta ya no es únicamente qué datos se introducen en un prompt, sino qué datos consulta el agente por su cuenta, qué conserva, qué infiere, qué comparte con otros servicios y qué acciones ejecuta después. En un sistema agéntico, el riesgo nace del comportamiento completo del flujo.

    La memoria, el punto más delicado

    Uno de los elementos que más preocupan a la AEPD es la memoria. La guía distingue entre memoria de trabajo, memoria a largo plazo y memoria de gestión, formada por registros o logs de operación. La memoria puede mejorar la utilidad del agente, porque permite recordar preferencias, casos anteriores o instrucciones de la organización. Pero también puede acumular datos personales, sesgos, credenciales, información irrelevante o contexto que no debería reutilizarse en otros tratamientos.

    La AEPD advierte de que la memoria debe estar compartimentada por tratamientos, casos y personas usuarias cuando sea necesario. No es lo mismo guardar políticas generales de la organización que conservar datos de un cliente, un empleado o un expediente. Si toda la información se vuelca en un repositorio común y se deja al agente decidir qué usar, el riesgo de quiebra del principio de minimización aumenta.

    También aparece el problema de la conservación. En protección de datos no se trata de guardar todo “por si acaso”. La información almacenada debe ser la mínima necesaria para el funcionamiento del agente y debe tener plazos claros de retención. La guía recomienda gestionar la memoria con capacidades de búsqueda, borrado, trazabilidad, limitación del tratamiento y alertas de uso.

    La Agencia propone medidas como desactivar memoria persistente por defecto en determinados tratamientos, permitir su desactivación por la persona usuaria, aplicar caducidades estrictas e higienizar la memoria a largo plazo. Esta higienización incluye eliminar credenciales innecesarias, revisar contenido obsoleto, detectar sesgos y depurar información que ya no sea relevante.

    Riesgos: opacidad, inyección de prompts y filtraciones silenciosas

    La AEPD no se queda en una advertencia genérica sobre “usar la IA con cuidado”. Identifica riesgos bastante concretos. Uno de ellos es la opacidad: si el agente combina inferencias, herramientas externas, memoria y acciones automáticas, puede ser difícil explicar por qué hizo algo, qué datos usó o qué componente falló. Esto afecta a la transparencia, a la supervisión humana y al ejercicio de derechos.

    Otro riesgo es el acceso excesivo a información. Un agente con permisos amplios puede consultar más datos de los necesarios, hacer scraping masivo o reenviar información a otros sistemas sin una base adecuada. Aquí el principio de minimización cobra especial importancia: el agente no debe tener acceso a todo porque “así funciona mejor”. Debe acceder solo a lo necesario para cada tarea.

    La inyección de prompts es otra amenaza central. Una instrucción maliciosa no siempre llega escrita por el usuario en la caja de texto. Puede estar escondida en una web, un correo, un PDF o un documento que el agente lee durante su trabajo. Si el sistema no filtra bien las entradas externas, el agente puede obedecer instrucciones que alteren su comportamiento, revelen datos o ejecuten acciones no previstas.

    La guía también menciona las filtraciones shadow-leak, un concepto importante para organizaciones que manejan información sensible. No se trata de una fuga directa y evidente, sino de una exposición silenciosa y progresiva de datos, reglas internas, memoria, patrones o secretos a través de respuestas parciales, metadatos, tiempos de respuesta o comportamientos del sistema. Precisamente por ser difícil de detectar, este riesgo exige controles desde el diseño.

    La “regla de 2” como alarma mínima

    Uno de los puntos más útiles de la guía es la llamada “regla de 2”, inspirada en criterios de seguridad aplicados a sistemas que ejecutan contenido no confiable. La AEPD la adapta al contexto de agentes de IA como umbral mínimo de garantías.

    La idea es sencilla: hay tres factores especialmente peligrosos si se combinan mal. El primero es tratar información no controlada, como correos, webs o documentos externos que pueden contener ataques. El segundo es acceder a información sensible o datos personales. El tercero es ejecutar acciones automáticas con efectos dentro o fuera de la organización.

    La AEPD advierte de que una configuración que combine los tres elementos sin garantías no debería permitirse. Por ejemplo, un agente que recibe correos no verificados, puede acceder a datos sensibles del usuario y además responde o modifica repositorios de forma automática representa una configuración de riesgo alto.

    Combinación de riesgoQué debería evitarse
    Entrada no controlada + acceso a datos sensiblesNo permitir acciones automáticas sin supervisión humana
    Acceso a datos sensibles + acciones automáticasNo operar sin garantías de integridad y seguridad de la información
    Entrada no controlada + acciones automáticasImpedir el acceso a información sensible o datos personales
    Entrada no controlada + datos sensibles + acción automáticaConfiguración que no debería permitirse sin rediseño y garantías reforzadas

    Esta regla no sustituye una evaluación de riesgos ni una evaluación de impacto cuando proceda, pero sirve como señal de alarma. Si un proyecto de agente cumple dos o tres de esos factores, no debería tratarse como una simple integración tecnológica.

    Qué deben hacer las organizaciones

    La AEPD plantea una respuesta estructural. No basta con poner un aviso al usuario o pedirle que revise la respuesta final. La IA agéntica debe incorporarse a la gobernanza del tratamiento desde el diseño, con participación del Delegado de Protección de Datos cuando exista, análisis de riesgos, documentación de finalidades, control de intervinientes, gestión de proveedores y medidas técnicas proporcionadas.

    La guía recuerda que la incorporación de IA agéntica puede cambiar la naturaleza del tratamiento. Puede modificar flujos de datos, categorías de información, plazos de conservación, destinatarios, finalidades y nivel de autonomía. Por eso puede exigir un nuevo ciclo de gestión del riesgo o revisar una evaluación de impacto ya realizada. No todos los casos obligarán automáticamente a una EIPD, pero sí habrá que justificarlo.

    Entre las medidas recomendables destacan la minimización granular, el filtrado de flujos entre componentes, la eliminación de metadatos innecesarios, la seudonimización de usuarios, el control de memoria y logs, las listas blancas de servicios, la definición del grado de autonomía y la supervisión humana real en las decisiones o acciones sensibles.

    Para empresas que empiezan a desplegar agentes, la lección práctica es clara: no se puede comprar una herramienta agéntica y conectarla a correos, CRM, expedientes, carpetas compartidas y sistemas internos sin rediseñar permisos, memoria y controles. Cuanto más útil sea el agente, más probable será que necesite acceso a datos valiosos. Y cuanto más acceso tenga, más exigente debe ser la gobernanza.

    La IA agéntica puede ser una tecnología útil para mejorar procesos y reducir tareas repetitivas, pero la AEPD recuerda que su adopción exige madurez. Un agente que actúa sin entender límites puede convertir una buena automatización en un problema de protección de datos. La innovación no queda prohibida; queda condicionada a algo que el RGPD lleva años exigiendo: responsabilidad proactiva, privacidad desde el diseño y control real sobre el tratamiento.

    Preguntas frecuentes

    ¿Qué son las orientaciones de la AEPD sobre IA agéntica?
    Son un documento publicado por la Agencia Española de Protección de Datos para ayudar a responsables y encargados a identificar riesgos cuando usan agentes de IA en tratamientos de datos personales.

    ¿La IA agéntica obliga siempre a hacer una evaluación de impacto?
    No siempre. Pero puede exigir una EIPD o la revisión de una ya existente si cambia el riesgo del tratamiento, los datos tratados, las finalidades, la autonomía o los flujos de información.

    ¿Qué es la regla de 2 en agentes de IA?
    Es una regla mínima de seguridad que alerta sobre la combinación de entradas no controladas, acceso a datos sensibles y acciones automáticas. Si esos factores se combinan mal, el agente puede generar riesgos graves.

    ¿Qué medidas recomienda la AEPD?
    Recomienda integrar la IA agéntica en la gobernanza del tratamiento, limitar accesos, minimizar datos, controlar memoria y logs, filtrar flujos entre componentes, seudonimizar cuando proceda y documentar el grado de autonomía del agente.

  • ¿De quién es el prompt? La nueva pregunta legal que llega a los despachos

    ¿De quién es el prompt? La nueva pregunta legal que llega a los despachos

    El prompt ha dejado de ser una instrucción improvisada para pedirle algo a una herramienta de inteligencia artificial. En muchos despachos, asesorías jurídicas y departamentos legales empieza a funcionar como una plantilla de trabajo, una metodología de análisis, una guía de revisión contractual o incluso una pieza reutilizable dentro de un servicio profesional. Y cuando una instrucción se convierte en método, conocimiento y ventaja competitiva, la pregunta aparece sola: ¿de quién es?

    La respuesta no cabe en una frase. Un prompt puede ser una orden simple, una estructura compleja, una combinación de datos internos, una secuencia de razonamiento jurídico o una plantilla desarrollada por un abogado para automatizar parte de su práctica. Según el caso, podrá quedar fuera de la protección, estar amparado por derechos de autor, integrarse en un secreto empresarial o depender de lo que digan los contratos laborales, mercantiles y de prestación de servicios.

    Información rápida para despachos y asesorías

    SupuestoRiesgo principalProtección más probableMedida práctica
    Prompt simple del tipo “resume este contrato”Escasa protección jurídicaNormalmente ninguna específicaNo tratarlo como activo protegido
    Prompt complejo con estructura originalDiscusión sobre originalidadDerecho de autor, si supera el umbral creativoConservar versiones y autoría humana
    Biblioteca interna de prompts jurídicosFuga de know-howSecreto empresarialAccesos limitados, NDA y repositorio controlado
    Prompt con datos de clientesBrecha de confidencialidad o RGPDCumplimiento, contrato con proveedor y secreto profesionalProhibir datos sensibles en herramientas no autorizadas
    Prompt creado por empleadoConflicto sobre titularidadContrato laboral y políticas internasRegular expresamente cesión, uso y reutilización
    Prompt creado por proveedor externoReutilización no deseadaContrato mercantilCláusulas de titularidad, exclusividad y confidencialidad

    Derecho de autor: no todo prompt es una obra

    La primera tentación es llevar el debate al terreno de la propiedad intelectual. En España, la Ley de Propiedad Intelectual protege las creaciones originales literarias, artísticas o científicas por el solo hecho de su creación. El punto decisivo no es que el prompt sea útil, sino que sea una expresión original atribuible a una persona. Una instrucción funcional y breve rara vez tendrá entidad suficiente para considerarse obra protegida.

    Esto deja fuera a la mayoría de prompts de uso cotidiano: “redacta una cláusula de confidencialidad”, “resume esta sentencia”, “haz una tabla de riesgos” o “compara estas dos versiones de contrato”. Son instrucciones operativas. Tienen una finalidad profesional, pero no necesariamente una forma expresiva original.

    El análisis cambia cuando el prompt se convierte en una estructura elaborada. Pensemos en una plantilla de revisión de contratos de outsourcing tecnológico que incluye criterios de riesgo, jerarquía de cláusulas, instrucciones de estilo, ejemplos, reglas de salida, ponderación por criticidad y advertencias de cumplimiento. Ahí puede existir una expresión suficientemente personal y compleja, aunque la protección no alcanzaría al método jurídico en abstracto, sino a la forma concreta en que se ha redactado y organizado.

    La doctrina internacional va con cautela. La Oficina de Copyright de Estados Unidos ha insistido en que la autoría humana sigue siendo necesaria para proteger obras generadas con ayuda de IA, y que un resultado producido únicamente por una máquina a partir de prompts puede no ser registrable si no hay contribución creativa humana suficiente. Ese criterio no decide el derecho español, pero muestra una tendencia relevante para despachos que trabajan con clientes internacionales.

    El prompt, el resultado y los datos no son lo mismo

    Para un abogado, conviene separar tres planos que a menudo se mezclan. El primero es el prompt como instrucción. El segundo son los datos que se introducen en la herramienta. El tercero es el resultado generado por el modelo. Cada uno plantea problemas distintos.

    El prompt puede contener know-how. Los datos pueden incluir información confidencial, datos personales, secretos de cliente o material sujeto a privilegio profesional. El resultado puede ser un borrador contractual, un informe de riesgos, una nota jurídica o una estrategia procesal. Que una plataforma diga que el usuario conserva derechos sobre las salidas no resuelve automáticamente la titularidad del prompt ni la licitud del tratamiento de datos introducidos.

    En despachos y departamentos legales, el mayor riesgo suele estar menos en la autoría y más en la confidencialidad. Un prompt que incorpora hechos de un asunto, nombres de partes, cuantías, estrategias, cláusulas no públicas o documentos de due diligence puede exponer información sensible si se introduce en una herramienta no autorizada. Además, no todos los servicios de IA tratan igual los datos: depende del proveedor, del tipo de cuenta, de la configuración, de si hay contrato empresarial y de las políticas de retención o entrenamiento.

    Desde el punto de vista del RGPD, si el prompt contiene datos personales hay tratamiento. Eso exige base jurídica, minimización, seguridad, información cuando proceda y análisis del proveedor como encargado o responsable, según el modelo de servicio. El Comité Europeo de Protección de Datos ha recordado que los modelos de IA pueden plantear cuestiones relevantes sobre anonimización, base jurídica e impacto del tratamiento de datos personales, por lo que no conviene asumir que todo uso de IA queda fuera del RGPD por el mero hecho de tratarse de una herramienta generativa.

    Secreto empresarial: la vía más sólida para prompts valiosos

    Para muchos despachos, la protección realista no estará en el derecho de autor, sino en el secreto empresarial. La Ley 1/2019 protege información o conocimiento que sea secreto, tenga valor empresarial precisamente por ser secreto y haya sido objeto de medidas razonables para mantenerlo reservado. Esa definición encaja mejor con bibliotecas internas de prompts, flujos de IA, metodologías de análisis y plantillas jurídicas optimizadas.

    Un prompt jurídico avanzado puede condensar años de experiencia: cómo detectar riesgos en contratos SaaS, qué revisar en una operación de M&A, cómo clasificar cláusulas de responsabilidad, cómo preparar un primer análisis de compliance o cómo convertir documentos extensos en una matriz útil para el socio responsable. Si ese conjunto aporta ventaja competitiva y no es conocido fuera del despacho, puede ser un activo protegible como secreto empresarial.

    Pero la protección no nace de decir “esto es confidencial” cuando ya se ha filtrado. Hay que demostrar medidas previas: repositorios con control de acceso, permisos por equipo, registros de cambios, cláusulas de confidencialidad, políticas de uso de IA, formación interna y límites claros para copiar prompts en herramientas externas. La diferencia entre un secreto empresarial y una buena práctica compartida en un chat interno puede depender de esas medidas.

    La arquitectura contractual es igual de importante. En contratos laborales debe aclararse si los prompts creados por abogados, paralegals o equipos de legal operations pertenecen al despacho cuando se desarrollan en el marco de su trabajo. En contratos con proveedores tecnológicos, consultores o colaboradores externos, conviene regular titularidad, reutilización, sublicencia, confidencialidad y devolución o destrucción de materiales. En proyectos para clientes, la cuestión puede ser aún más delicada: un prompt creado para un cliente puede no ser reutilizable en otro si incorpora metodología, datos o criterios específicos del primero.

    IA Act, gobierno interno y práctica profesional

    El Reglamento Europeo de Inteligencia Artificial no convierte automáticamente un prompt en activo protegido, pero sí refuerza la necesidad de gobernanza. La norma crea un marco para el desarrollo, puesta en servicio y uso de sistemas de IA en la Unión, con obligaciones distintas según el tipo de sistema y riesgo. Para los despachos, el mensaje práctico es que la IA debe entrar en procedimientos internos, no quedarse en usos informales de cada abogado.

    Una política razonable debería distinguir entre prompts públicos, internos, confidenciales y prohibidos. También debería identificar herramientas aprobadas, categorías de datos que no pueden introducirse, reglas para clientes regulados, revisión humana de outputs, conservación de evidencias y responsabilidades dentro del despacho.

    Los prompts que afecten a asesoramiento jurídico, decisiones procesales, análisis de cumplimiento o documentos destinados a cliente no deberían circular sin control. Pueden versionarse como si fueran modelos de contrato: autor, fecha, cambios, aprobador, ámbito de uso y advertencias. Esta disciplina no busca frenar la IA, sino evitar que cada profesional construya su propio sistema de riesgo en paralelo.

    La pregunta “¿de quién es el prompt?” será cada vez más frecuente en tres escenarios: salida de profesionales del despacho, conflictos con proveedores que reutilizan plantillas, y clientes que exigen saber cómo se ha usado IA en la prestación del servicio. Quien haya documentado titularidad, confidencialidad y control tendrá una posición mucho más fuerte.

    Los prompts no sustituyen al criterio jurídico. Pero pueden capturarlo, empaquetarlo y multiplicarlo. Por eso no deben tratarse como texto desechable. En los próximos años, muchos despachos descubrirán que parte de su ventaja no está solo en sus documentos finales, sino en las instrucciones internas que permiten producirlos mejor, más rápido y con menos errores. La propiedad de esas instrucciones dependerá menos de grandes teorías sobre la IA y más de algo muy conocido por los abogados: prueba, contrato y medidas razonables de protección.

    Preguntas frecuentes

    ¿Un prompt jurídico puede estar protegido por derechos de autor?
    Sí, pero solo en casos concretos. Una instrucción simple difícilmente estará protegida. Un prompt complejo, original y expresado con una estructura creativa puede tener más opciones.

    ¿Puede un despacho proteger sus prompts como secreto empresarial?
    Sí, si son secretos, tienen valor competitivo y el despacho adopta medidas razonables para mantenerlos reservados, como control de accesos, cláusulas de confidencialidad y políticas internas.

    ¿Qué ocurre si un abogado introduce datos de cliente en una herramienta de IA?
    Puede haber riesgos de confidencialidad, secreto profesional y protección de datos. El despacho debe revisar proveedor, contrato, configuración, base jurídica, retención y uso posterior de la información.

    ¿A quién pertenecen los prompts creados por empleados o colaboradores?
    Depende del contrato, del contexto de creación y de las políticas internas. Lo recomendable es regular expresamente titularidad, cesión, reutilización y deberes de confidencialidad.

  • La AEPD endurece las sanciones y acelera la adopción de soluciones para la protección de datos en los concesionarios

    La AEPD endurece las sanciones y acelera la adopción de soluciones para la protección de datos en los concesionarios

    En 2025, la Agencia Española de Protección de Datos impuso un total de 299 sanciones a empresas, con una recaudación de 40 millones de euros, lo que supone un incremento del 14% respecto a los 35 millones registrados en 2024. Este repunte refleja un mayor control sobre el cumplimiento del Reglamento General de Protección de Datos, especialmente en sectores que gestionan un alto volumen de información personal, como el de la automoción.

    En este ámbito, los concesionarios trabajan con grandes cantidades de datos a través de distintos canales, como la venta de vehículos, la financiación, el marketing o los servicios posventa. Esta complejidad, unida a la interacción constante con fabricantes y diversas plataformas tecnológicas, incrementa el riesgo de incumplimiento normativo.

    Ante esta situación, el vicepresidente regional para Iberia de Nextlane, Luca Liberali, destaca que contar con herramientas que aseguren una gestión adecuada del consentimiento ha pasado de ser una opción a convertirse en una necesidad estratégica para las empresas del sector.

    La solución que impulsa la gestión del consentimiento

    Ante este escenario, las compañías tecnológicas están reforzando su oferta con herramientas específicas para la gestión del consentimiento. Nextlane, líder europeo en soluciones de software para la industria de la automoción, cuenta con Consent Center, una solución que permite a concesionarios y empresas del sector gestionar el consentimiento de los clientes de forma centralizada, segura y conforme al RGPD.

    Este sistema facilita la recogida, almacenamiento y trazabilidad del consentimiento, garantizando que las empresas puedan demostrar en todo momento cuándo, cómo y para qué un cliente autorizó el uso de sus datos.

    La automatización y el control de los datos mejora también la eficiencia operativa

    El Consent Center de Nextlane se integra con los sistemas del concesionario, como el DMS y el CRM. Las ventajas de su integración para los concesionarios no se quedan solo en el cumplimiento normativo, sino que permiten mejorar la eficiencia operativa al reducir el tiempo en la gestión documental y centralizar la información.

    Asimismo, disminuye el riesgo legal mediante la automatización de procesos, así como también ofrece a los concesionarios datos fiables y de acceso rápido sobre sus clientes para generar y desarrollar acciones comerciales y de marketing.

    Gracias a esta integración, se evita la dispersión de información y se mejora la coherencia en el tratamiento de datos, ya que permite:

    • Recopilar el consentimiento directamente desde el DMS.
    • Consultar el historial completo de cada cliente.
    • Generar y gestionar formularios de forma ágil.
    • Garantizar una gestión adecuada de los datos.

    En un escenario donde las sanciones aumentan y la exigencia regulatoria se intensifica, la digitalización de la gestión del consentimiento se posiciona como un elemento clave para la sostenibilidad del negocio.

    En este entorno, la adopción de soluciones tecnológicas específicas como el Consent Center de Nextlane se consolida como una vía para garantizar el cumplimiento normativo y mantener la operativa del negocio sin asumir riesgos innecesarios.