
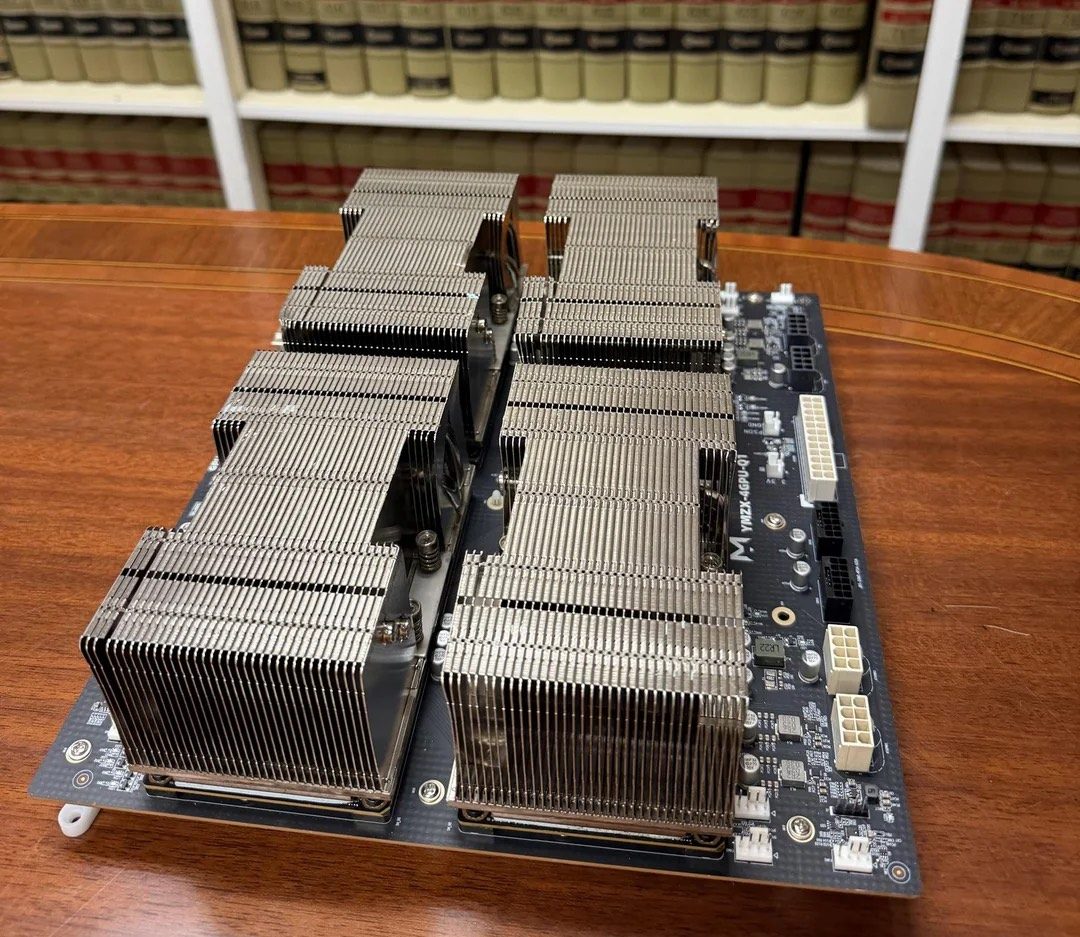
Un abogado ha construido un servidor de inteligencia artificial (IA) con ocho GPU NVIDIA Tesla V100 de segunda mano para procesar expedientes jurídicos sin enviar documentos fuera de su oficina. El sistema utiliza dos placas SXM2 con cuatro GPU cada una, conectadas mediante NVLink, y ejecuta el modelo abierto DeepSeek V4.1 Flash con velocidades de hasta 215 tokens por segundo en determinadas pruebas. El coste declarado fue de unos 2.400 dólares por cada conjunto de cuatro GPU, placa y electrónica de conexión, aproximadamente 4.800 dólares en total.
Las claves del servidor privado de IA con ocho NVIDIA V100 en 30 segundos
- Un abogado ha construido un servidor local con ocho NVIDIA Tesla V100 de 32 GB, tarjetas de centro de datos lanzadas en 2018.
- Las GPU se distribuyen en dos placas SXM2 de cuatro unidades, con 128 GB de memoria HBM2 por placa y conexiones NVLink internas.
- El equipo ejecuta DeepSeek V4.1 Flash con todos sus expertos en memoria de GPU y un contexto de hasta 524.000 tokens.
- El autor declara velocidades de hasta 215 tokens por segundo en código y 118 en redacción jurídica con prompts de 1.000 tokens.
- El objetivo es mantener los expedientes dentro de la oficina y reducir la dependencia de servicios de IA externos.
El proyecto, publicado en la comunidad r/homelab de Reddit por el usuario TumbleweedNew6515, muestra una alternativa a contratar capacidad de inferencia mediante API o utilizar servicios comerciales en la nube. Su planteamiento parte de una necesidad concreta: trabajar con documentación jurídica sensible sin que los expedientes tengan que salir de la infraestructura del despacho.
El abogado asegura que el servidor ya procesa entre el 50 % y el 60 % de sus flujos de trabajo actuales con modelos de lenguaje (LLM). Entre las tareas que realiza están leer carpetas de documentos, extraer hechos, fechas y cantidades, preparar resúmenes y generar primeros borradores de textos rutinarios. El profesional afirma que revisa los resultados antes de utilizarlos.
La experiencia también incluye bases de datos de generación aumentada por recuperación (RAG) y llamadas a herramientas. El usuario controla el sistema desde un ordenador Windows mediante una interfaz similar a Discord que funciona a través de SSH. Además, dispone de otro servidor DeepSeek basado en dos NVIDIA DGX Spark para repartir parte del trabajo manual.
Ocho GPU V100 de 2018 para reunir 256 GB de memoria gráfica
La configuración utiliza ocho NVIDIA Tesla V100-SXM2 de 32 GB, aceleradores de centro de datos basados en arquitectura Volta y memoria HBM2. Cada GPU ofrece un ancho de banda de memoria declarado de 900 GB/s.
Las tarjetas se distribuyen en dos placas base SXM2 de cuatro GPU. Dentro de cada placa, las cuatro unidades se comunican mediante NVLink, lo que proporciona 128 GB de memoria gráfica por conjunto. Entre las dos placas, sin embargo, la comunicación se realiza mediante PCI Express (PCIe), una diferencia importante para distribuir modelos grandes entre las ocho GPU.
El resto de la configuración incluye:
- Dos placas SXM2 con cuatro Tesla V100 de 32 GB cada una.
- Cuatro tarjetas de conmutación PEX para gestionar las conexiones PCIe.
- Cableado SlimSAS entre los componentes.
- Una placa base Gigabyte para Threadripper PRO.
- Un procesador AMD Threadripper PRO 3945WX de 12 núcleos.
- 256 GB de memoria DDR4 RDIMM, distribuidos en ocho módulos de 32 GB.
- Controladores NVIDIA de la rama R580.
El coste es uno de los aspectos más llamativos del montaje. El propietario explica que pagó unos 1.600 dólares por cuatro V100 SXM2 de 32 GB con sus disipadores y alrededor de 750 dólares por la placa y la tarjeta PEX. El conjunto se situó así cerca de los 2.400 dólares por 128 GB de memoria gráfica NVLink.
Con dos conjuntos, el coste declarado ronda los 4.800 dólares. Son precios históricos de compra, no una tarifa actual del mercado. El propio autor recomienda comprobar las ofertas de eBay y Alibaba antes de tomar esas cifras como referencia.
El equipo también requiere una infraestructura eléctrica y térmica considerable. El límite de potencia se ha fijado en 150 W por GPU y la frecuencia gráfica está limitada a 1.522 MHz. Inicialmente, las dos fuentes de alimentación se conectaron a circuitos eléctricos independientes de la oficina, con una capacidad conjunta de 2.800 W.
DeepSeek V4.1 Flash alcanza 215 tokens por segundo en las pruebas
La distribución del modelo es una de las decisiones técnicas más importantes del proyecto. El usuario explica que dividir todas las capas entre las ocho GPU puede provocar una caída de rendimiento porque las dos placas no están conectadas entre sí mediante NVLink.
Para evitarlo, utiliza una configuración de paralelismo por etapas (pipeline parallelism) de dos grupos y paralelismo tensorial de cuatro GPU por grupo (PP2 x TP4). Las capas 0 a 19 se ejecutan en una placa y las capas 20 a 39 en la otra. Así, cada conjunto mantiene la mayor parte del tráfico de comunicación dentro de su propia conexión NVLink y solo necesita transferir información entre placas durante el paso correspondiente.
La cuantización de dos bits reduce el tamaño de los pesos del modelo a 248,8 GB. Sin embargo, hay una precisión importante en la descripción del proyecto: no todos los datos permanecen en la memoria gráfica. Los expertos del modelo sí están en la VRAM, pero las tablas Engram, que ocupan 110 GB, residen en la memoria RAM del sistema. El acceso a las filas necesarias añade, según el autor, unos 0,12 milisegundos por ronda.
Las mediciones publicadas corresponden al 05/11/2026, con generación de 1.024 tokens, decodificación greedy, sin reutilización de prefijos en caché y un promedio de dos ejecuciones.
| Prompt | Primer token | Código | Redacción jurídica |
|---|---|---|---|
| 1K tokens | 1,2 s | 215 tok/s | 118 tok/s |
| 32K tokens | 17,2 s | 200 tok/s | 117 tok/s |
| 128K tokens | 59,2 s | 183 tok/s | 111 tok/s |
| 256K tokens | 118,7 s | 160 tok/s | 103 tok/s |
Los resultados muestran cómo aumenta el tiempo necesario para obtener el primer token a medida que crece el contexto. También reflejan una diferencia entre la generación de código y la redacción jurídica. El autor atribuye parte de esa ventaja a un modelo de borrador pequeño que anticipa cinco tokens para acelerar la generación especulativa, con mejores resultados cuando el contenido es código.
El responsable del montaje también declara una velocidad de lectura del prompt de unos 2.200 tokens por segundo con contextos de 128.000 tokens. En cuanto a la calidad, publica una puntuación de 0,716 en LegalBench, una evaluación con 22 tareas, un 79,9 % en MMLU-Pro y la recuperación de seis de seis referencias ocultas en una prueba de contexto de aproximadamente 500.000 tokens. Son resultados comunicados por el propio autor, no una evaluación independiente del rendimiento general del sistema.
Los problemas de PCIe, memoria y alimentación también forman parte del proyecto
El montaje no ha estado libre de dificultades. El autor describe varios problemas durante las pruebas, entre ellos reinicios del sistema asociados a errores PCIe de tipo Completion Timeout. Los incidentes aparecieron con límites de potencia más altos y frecuencias sin restringir.
En esas condiciones, algunas GPU llegaron a registrar consumos de entre 192 y 232 W frente a un límite configurado de 180 W. El usuario plantea como hipótesis que los picos de carga provocaban problemas en el enlace PCIe de una de las placas, aunque reconoce que no ha demostrado esa explicación. Tras limitar las frecuencias y reducir el consumo, los reinicios dejaron de producirse.
También detectó una marca de quemadura en un conector de alimentación de una de las placas SXM2. Otro problema apareció en la memoria DDR4-3200, donde un canal registró cuatro errores ECC no corregibles. Tres de ellos se produjeron durante la carga del modelo y provocaron la caída de dos procesos de trabajo.
La solución fue reducir la frecuencia de la memoria a DDR4-2666. Después, tres rondas de una prueba de memoria de 200 GB terminaron sin errores, y los contadores se mantuvieron limpios durante las comprobaciones posteriores.
El autor también detectó una GPU que negociaba un enlace PCIe x4 en lugar de x8. Posteriormente confirmó que había solucionado ese problema, aunque no actualizó inicialmente todos los detalles de la publicación.
Otro cambio en la distribución de los switches PEX mejoró aproximadamente un 2 % el tiempo hasta el primer token en prompts largos, sin cambios apreciables durante la generación. El propio responsable del montaje describe esta mejora como un ajuste menor, no como una transformación del rendimiento.
La experiencia deja una cuestión práctica para quienes valoran construir servidores de IA con aceleradores antiguos: el precio de las GPU no representa el coste completo. Hay que contar con placas SXM2, electrónica PCIe, alimentación, refrigeración, cableado y tiempo de configuración. También hay que tener presente que la rama R580 es la última que, según el autor, mantiene soporte para Volta, por lo que la continuidad del software puede limitar la vida útil del equipo.
El proyecto demuestra que es posible reunir una capacidad considerable de memoria gráfica mediante aceleradores usados y ejecutar modelos abiertos de gran tamaño en una infraestructura propia. Para el abogado, la ventaja principal es mantener los documentos bajo su control. La contrapartida es una plataforma compleja, con un consumo elevado y un mantenimiento que exige conocimientos de hardware, controladores y distribución de cargas entre GPU.
Preguntas frecuentes
¿Cuánto cuesta montar un servidor de IA con ocho NVIDIA V100?
El propietario calcula que pagó unos 2.400 dólares por cada conjunto de cuatro GPU con placa y electrónica de conexión. Para las ocho tarjetas, el coste declarado ronda los 4.800 dólares, sin que esa cifra deba considerarse un precio actual de mercado.
¿Qué modelo de IA ejecuta el servidor?
El equipo ejecuta DeepSeek V4.1 Flash con cuantización de dos bits. El autor utiliza dos grupos de cuatro GPU y mantiene los expertos del modelo en memoria gráfica.
¿Qué velocidad alcanza el servidor con ocho V100?
En las pruebas publicadas alcanza hasta 215 tokens por segundo en generación de código y 118 tokens por segundo en redacción jurídica con prompts de 1.000 tokens. Con un contexto de 256.000 tokens, las velocidades bajan a 160 y 103 tokens por segundo, respectivamente.
¿Por qué utiliza ocho GPU antiguas en lugar de aceleradores actuales?
El planteamiento busca conseguir un conjunto amplio de memoria gráfica NVLink a un coste reducido mediante hardware de segunda mano. El propietario prioriza ejecutar modelos localmente y mantener los expedientes jurídicos dentro de su oficina.
Fuentes:


